Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Vetted Pro
Level 1


El equipo de Fiverr Pro seleccionó a Zlatin S por su experiencia.
Traducción automática
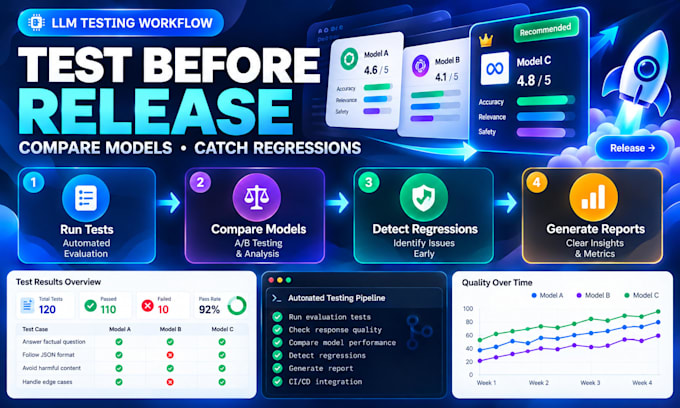
Tu aplicación de IA funciona hoy. ¿seguirá funcionando después de una actualización de modelo o de prompt?
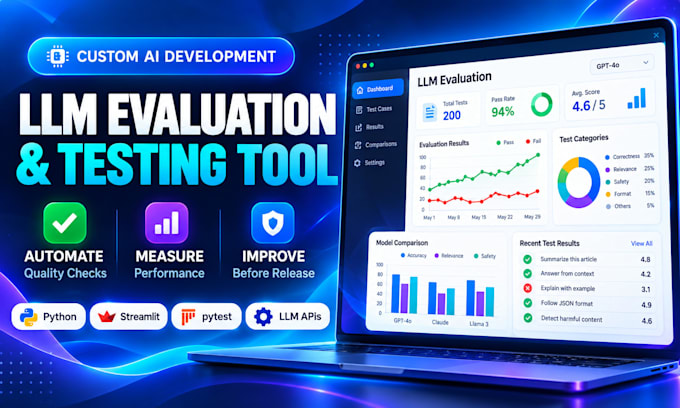
Construyo herramientas de evaluación de LLM basadas en Python que ayudan a los equipos a detectar errores, seguir la calidad de las respuestas y detectar regresiones antes del lanzamiento.
LO QUE CONSTRUYO
PAQUETES
Básico: 25 casos de prueba, 2 comprobaciones y un panel de resultados sencillo.
Estándar: 75 casos de prueba, 3 criterios, panel de análisis detallado.
Premium: 150 casos de prueba, 4 criterios, comparación y automatización de CI.
LO QUE RECIBES
Código fuente en Python, archivos de pruebas de evaluación, exportaciones de resultados, instrucciones de configuración y una demo.
Alcance: un flujo de trabajo acordado en inglés. Cargos de API del modelo, hosting, ajuste fino y monitoreo continuo quedan fuera. No hay garantía de cero alucinaciones en un sistema de evaluación.
Por favor envíame un mensaje antes de hacer el pedido para confirmar tu API, datos de prueba y criterios de aceptación.
Vetted Pro
Senior AI and Full Stack Engineer
Level 1
Zlatin S es parte del catálogo de Fiverr Pro y un equipo especializado de Fiverr Pro lo ha seleccionado con cuidado por sus habilidades y experiencia.
Revisado para
Desarrollo de IA
Idiomas
Traducción automática
Traducción automática
¿Qué tipos de aplicaciones de IA puedes evaluar?
Puedo crear pruebas para APIs de LLM basadas en texto, chatbots y aplicaciones de IA similares. Flujos de trabajo más complejos con agentes o multimodales requieren un alcance personalizado.
¿Qué proveedores de LLM soportas?
Apoyo endpoints compatibles con OpenAI y otros proveedores con APIs accesibles, sujeto a confirmar sus requisitos de integración antes del proyecto.
¿Puedes detectar alucinaciones de IA?
Puedo implementar comprobaciones de concreción y referencias cuando sea data disponible. Estas verificaciones ayudan a identificar posibles alucinaciones, pero no pueden garantizar una detección impecable.
¿Puedes probar un chatbot RAG?
Sí, dentro de un alcance de evaluación de respuestas acordado. Las pruebas avanzadas de recuperación de documentos, verificación de citas y pruebas end-to-end de RAG pueden requerir una oferta personalizada.
¿Recibiré el código fuente completo?
Sí. Proporciono el código fuente en Python acordado, casos de prueba, informes de evaluación y las instrucciones de configuración.
¿Puedo ejecutar las pruebas después de la entrega?
Sí. El marco está diseñado para ejecución repetida usando tu acceso a API configurado y tu entorno local.
¿El uso de API y el hosting están incluidos?
No. El uso de modelos de terceros, créditos de API, hosting en la nube y monitoreo continuo no están incluidos en el precio del paquete.
¿Qué se incluye en una revisión?
Una revisión cubre correcciones y ajustes dentro de las especificaciones acordadas. Nuevos modelos, integraciones o características importantes requieren una cotización por separado.