Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Bioinformática, Knockout Virtual, Dinámica Molecular, RNAseq, DTA
Validaré las SMILES de los compuestos y las secuencias de proteínas, ejecutaré un modelo de afinidad existente y devolveré predicciones coincidentes, estado por fila, una tabla clasificada y notas del modelo/verión. Básico: hasta 1.000 pares y 20 proteínas.
Rutas disponibles: DTA bilineal, DeepDTA, GraphDTA y una variante de atención cruzada derivada de MolTrans en ChemBERTa con reparación de máscara de longitud.
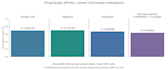
Nuestros registros guardados usan etiquetas pKi/pKd derivadas de BindingDB Ki/Kd, particiones NPZ congeladas y evaluación de objetivo en frío (proteínas de prueba reservadas del entrenamiento). Índices de concordancia: bilineal 0.695145; DeepDTA 0.702238; GraphDTA 0.668996; variante reparada derivada de MolTrans 0.636565. Estos son registros de puntos de control específicos de la ruta, no una comparación de prueba compartida.
Envía columnas CSV: sample_id, smiles y protein_sequence; añade compound_id/target_id si están disponibles. Confirma el modelo y la clasificación por objetivo. Las predicciones apoyan la priorización de candidatos.
Los pesos y los paquetes de implementación ejecutables pueden ser proporcionados por un acuerdo separado tras las comprobaciones de activos y distribución. Múltiples modelos, reentrenamiento y nuevas divisiones de validación son alcances distintos. Envíame un mensaje antes de ordenar.

Experiencia:
clasificación
•
Análisis predictivo
Lenguaje de programación:
Python
Marcos:
PyTorch
