Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
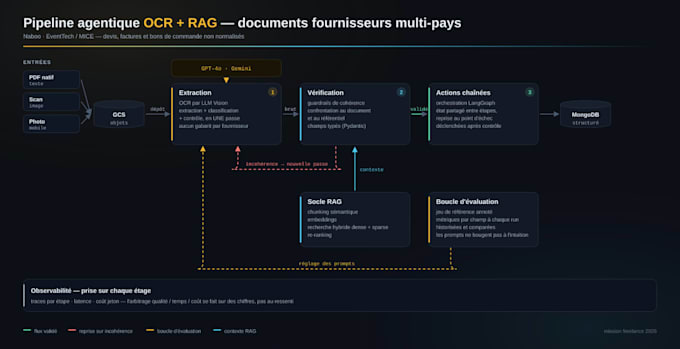
La mayoría de las demos de RAG fallan en producción porque la recuperación es incorrecta, no el modelo. Yo configuro la recuperación correctamente: segmentación semántica, embeddings, búsqueda híbrida densa+dispersa, re-ranking, y lo mido con un conjunto de evaluación, así cada cambio es un número, no una impresión.
Lo que obtienes: un chatbot que responde desde TUS documentos, cita sus fuentes y dice "No sé" cuando debería. Entregado como una API (FastAPI) con un chat web, en Docker, con trazas y coste por consulta.
Pila tecnológica: Python, LangChain/LangGraph, Qdrant o Elasticsearch, OpenAI/Gemini/Mistral o modelos abiertos en tu infraestructura.
Trabajos recientes: motor RAG en producción para dos marcas minoristas (grupo Mulliez), pipeline OCR+RAG para una startup de EventTech, motor anti-fraude de documentos para un banco.
Ingeniero senior de IA, más de 6 años, con base en Francia. Lidero equipos de 2 a 5 ingenieros.
Senior AI Engineer
Idiomas
Traducción automática
Traducción automática
¿Qué LLM utilizas?
Tu elección: OpenAI, Gemini, Mistral, o un modelo abierto alojado en tu lado para confidencialidad. Recomiendo uno basado en tus documentos y presupuesto.
Mis documentos son PDFs escaneados. ¿Es un problema?
No. OCR con visión por LLM forma parte del pipeline: se manejan escaneos, fotos y diseños no estándar.
¿Dónde funciona el chatbot?
En Docker en tu servidor o en tu nube (GCP, Azure, AWS). Nada queda en mi lado después de la entrega.
¿Cómo sé que funciona?
Obtienes un conjunto de evaluación: tus preguntas, las respuestas esperadas y una puntuación por versión. Cada cambio se mide, no se adivina.