Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Indícame qué sitio web público y qué campos necesitas, y te los entrego en un archivo XLSX y CSV limpios.
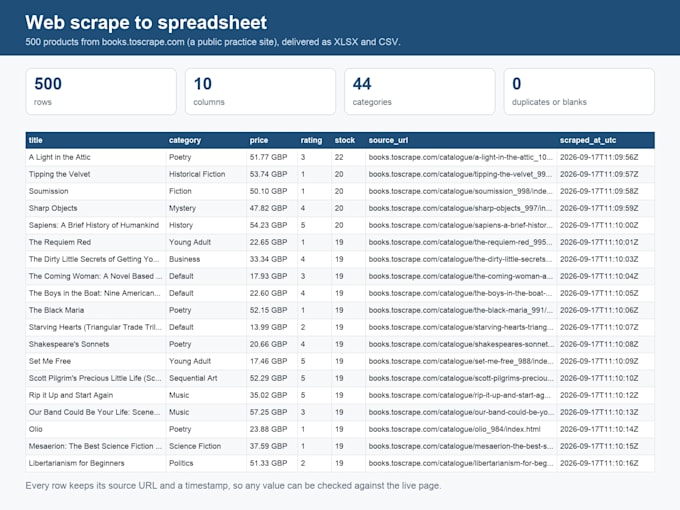
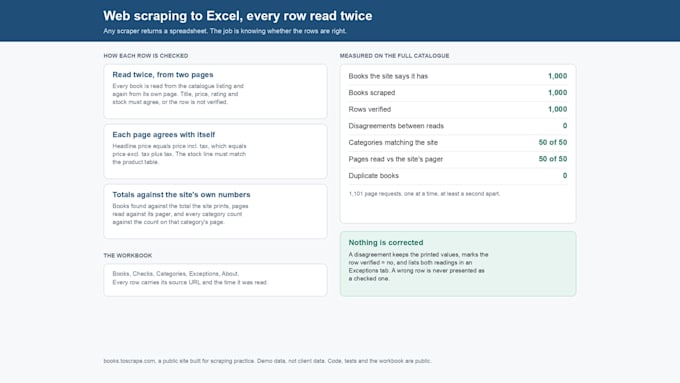
Cada fila conserva su URL de origen y la hora en que fue recopilada, para que puedas verificar cualquier valor con la página en vivo. Elimino duplicados, reviso por vacíos y añado una pestaña de resumen. Mis scripts envían una solicitud a la vez con una pausa, para no sobrecargar el sitio.
En mi muestra recopilé 500 productos en 44 categorías sin duplicados ni vacíos. Está en mi portafolio.
Lo que no hago: sitios detrás de un login, datos personales de individuos (nombres con correos o números de teléfono), o cualquier cosa que claramente prohíban los términos del sitio. Envíame el URL primero y te diré honestamente si se puede hacer y cuánto cuesta. Trabajo en inglés y francés.


Tecnología:
Python
•
Excel
•
Beautiful Soup
•
Playwright
•
Pandas
Técnica:
Automatizado
Traducción automática
¿Es legal el web scraping?
Recopilar datos públicos, no personales, a un ritmo respetuoso está bien en la mayoría de los lugares. Primero reviso los términos del sitio y el archivo robots, nunca hago scraping detrás de un login y no recopilo datos personales de individuos. Si un sitio está fuera de límites, te lo digo antes de que pagues.
¿Puedes hacer scraping en un sitio que requiere login o tiene captcha?
No. Solo trabajo en páginas que cualquiera puede abrir sin cuenta, y no bypasso captchas ni muros anti-bot. Si los datos están disponibles mediante una API oficial o exportación, usaré eso y te lo diré.
¿Qué pasa si algunos valores están mal o faltan?
Cada fila tiene su URL de origen, así que puedes indicarme la página exacta. Corrijo la extracción y la vuelvo a correr el mismo día. Las revisiones son ilimitadas hasta que el archivo coincida con el sitio.