Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador Full Stack React, Angular, WP, Ingeniero en Computer Vision
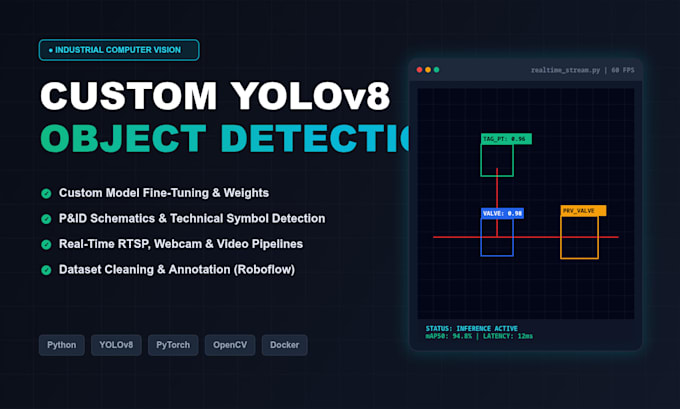
¿Buscas una solución lista para producción en Computer Vision y detección de objetos? Me especializo en entrenar, optimizar y desplegar modelos YOLO de alto rendimiento adaptados a tus especificaciones personalizadas.
Con experiencia industrial afinando arquitecturas YOLO en conjuntos de datos del mundo real en Larsen & Toubro Construction, entrego pipelines robustos diseñados para precisión y baja latencia.
Servicios ofrecidos:
Pila tecnológica: Python, YOLOv8, PyTorch, OpenCV, Roboflow, CUDA, Docker
¿Por qué elegir este gig?
Por favor, envíame un mensaje con los detalles de tu dataset y requisitos del proyecto antes de hacer un pedido para asegurar el mejor enfoque técnico.
Experiencia:
Procesamiento de imágenes
•
Detección de objetos
Lenguaje de programación:
Python
•
Colab
Herramientas:
Jupyter Notebook
•
opencv
•
PyTorch
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Traducción automática
¿Qué debo proporcionar antes de iniciar el proyecto?
Proporciona una breve descripción de los objetos que deseas detectar, el entorno objetivo (webcam, CCTV, archivos de video) y tu dataset (imágenes o grabaciones de video). Si aún no tienes un dataset anotado, selecciona el paquete Standard o Premium para que me encargue de la limpieza y anotación.
¿Qué pasa si mi dataset es pequeño o aún no está etiquetado?
En los paquetes Standard y Premium, las imágenes en bruto se limpian, anotan con cuadros delimitadores y se aumentan usando Roboflow y OpenCV para ampliar la diversidad del dataset y mejorar la generalización del modelo.
¿Cómo puedo ejecutar y probar el modelo en mi computadora?
Cada paquete entrega código fuente en Python limpio, pesos del modelo entrenados en .pt, un archivo de requisitos y documentación clara de configuración. Recibirás un script de inferencia sencillo para que puedas probar detección en imágenes, videos o en tu webcam en cuanto lo desees.
¿Necesito una GPU costosa para ejecutar el modelo?
El entrenamiento se realiza en hardware dedicado (como entornos CUDA/PyTorch), pero el modelo exportado puede hacer inferencias en CPUs estándar, GPUs locales o servidores en la nube. Si necesitas baja latencia, el modelo también puede optimizarse o containerizarse con Docker para un despliegue ligero.
¿Podemos discutir requisitos personalizados antes de ordenar?
Sí. Haz clic en el botón Contactar al vendedor para enviar el alcance de tu proyecto, imágenes de muestra o casos específicos antes de hacer un pedido, así se puede confirmar la arquitectura y nivel adecuados.