Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
¿Buscas anotaciones de datasets precisas y listas para producción para tus modelos de visión por computadora y YOLO?
Ofrezco etiquetado profesional de imágenes y fotogramas de video usando Roboflow, asegurando anotaciones precisas, gestión limpia del dataset y formatos de exportación listos para entrenar el modelo.
Lo que ofrezco:
¿Por qué elegir este gig?
¿Tienes requisitos específicos o un proyecto a gran escala? Envíame un mensaje con los detalles de tu dataset y las clases antes de hacer el pedido, y ¡empecemos!


Técnica:
Manual
Tipo de etiquetado:
Texto
•
Imagen
•
Video
Traducción automática
¿Puedes trabajar directamente dentro de mi espacio de Roboflow?
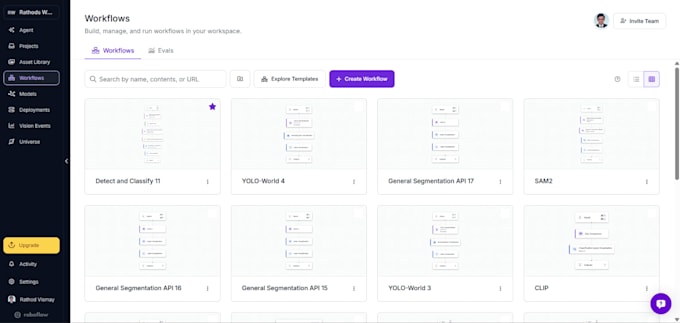
Sí. Puedes invitarme como anotador o colaborador a tu proyecto de Roboflow y etiquetar, revisar y organizar el dataset directamente en tu espacio de trabajo sin descargar tus archivos sin procesar.
¿Las anotaciones están listas para entrenamiento inmediato en YOLO?
Sí. Genero exportaciones limpias configuradas específicamente para YOLO (v8, v9, v11). Recibes coordenadas normalizadas de cuadros delimitadores en formato .txt junto con un archivo data.yaml preconfigurado para empezar el entrenamiento de inmediato.
¿Te encargas de las divisiones de train, validación y test?
Sí. Cada dataset se divide usando particiones óptimas (típicamente 70/20/10 o 80/20) con distribuciones de clases equilibradas, evitando fuga de datos y sesgo del modelo durante el entrenamiento.
¿Qué pasa si solo tengo archivos de video sin extraer?
Puedo extraer el video en fotogramas individuales a la velocidad de cuadro que necesites (FPS), filtrar fotogramas borrosos o redundantes y etiquetar solo los fotogramas relevantes para reducir el tamaño del dataset y los costos de entrenamiento.