Explorar las categorías
Explora
Fiverr Pro
Español
$
USD



Traducción automática
¿Quieres agregar AI a tu app sin una demo frágil y a medias? Integro ChatGPT, Claude y otros LLMs en tu producto o backend existente, con código limpio, probado y listo para producción.
Soy ingeniero de backend y AI con más de 5 años de experiencia. Construí una plataforma RAG completa en solitario usando FastAPI y pgvector, implementé funciones de AI con llamadas a herramientas y medidas de seguridad, y reduje los costos de LLM hasta en un 90% con caching de prompts, para que tu función siga siendo económica de ejecutar.
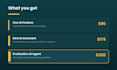
Lo que puedes ordenar:
Funciona con Python (FastAPI), Java (Spring Boot), Node y la mayoría de las stacks. Disponibles complementos para funciones adicionales y soporte prioritario.
Envíame un mensaje antes de ordenar con tu stack y lo que quieres que haga la AI, y confirmaré el alcance y el paquete adecuado. Respuestas rápidas, comunicación clara, entrega sencilla.
Backend and AI Engineer specializing in LLM, RAG, and Deployment
Idiomas
Traducción automática
Traducción automática
¿Trabajas con OpenAI/ChatGPT y Claude (Anthropic)?
Sí, ambos, además de otros LLMs importantes. He implementado integraciones en producción con OpenAI GPT-4 y Anthropic Claude. Si no estás seguro de cuál se ajusta a tu caso de uso y presupuesto, dime tu objetivo y te recomendaré uno y explicaré las ventajas y desventajas.
¿Esto funcionará con mi código y stack tecnológico actual?
Sí. Integro en tu base de código actual en lugar de reconstruirla. Trabajo regularmente con Python/FastAPI y Java/Spring Boot, además de Node y las stacks más comunes. Comparte tu repositorio y confirmaré que es compatible antes de que hagas el pedido.
¿Qué necesitas de mí para empezar?
Acceso a tu código o repositorio, una breve descripción de lo que debe hacer la AI y tu clave API de LLM. Para un asistente RAG, también los documentos o datos en los que basarse. Te enviaré una lista de verificación breve una vez que definamos el alcance del trabajo.
¿De quién son las claves API y quién paga el uso?
Tú eres dueño de las claves API y pagas directamente al proveedor, así mantienes control total sin recargo. Optimizó los prompts y uso caching cuando es posible para mantener bajos tus costos operativos.
¿No estás seguro de qué paquete necesitas?
Envíame un mensaje primero. En resumen: Básico = una función de AI; Estándar = un asistente basado en tus datos (RAG); Premium = un agente que realiza acciones a través de tus APIs. Dime tu objetivo y te indicaré el nivel adecuado o te enviaré una oferta personalizada.
¿Obtendré el código fuente y mi equipo podrá mantenerlo?
Sí. Recibirás todo el código fuente, bien escrito y comentado, además de notas sobre cómo funciona. Explico la integración para que tu equipo pueda mantenerla y ampliarla. Nada está bloqueado a mí.
¿Mis datos se mantienen confidenciales?
Sí. Solo uso tus datos para construir y probar tu integración, nunca para otra cosa, y puedo firmar un NDA. Para RAG, tus documentos permanecen en tu propia base de datos o infraestructura.
¿Puedes hacer que mi función de AI sea más barata de ejecutar?
A menudo, sí. En proyectos anteriores, he reducido los costos de LLM hasta en un 90% usando caching de prompts, enrutamiento de modelos y prompts más precisos. Dime tu configuración actual y te sugeriré dónde se pueden reducir los costos.


