Explorar las categorías
Español
$
USD
Conéctate con tu IA
Traducción automática
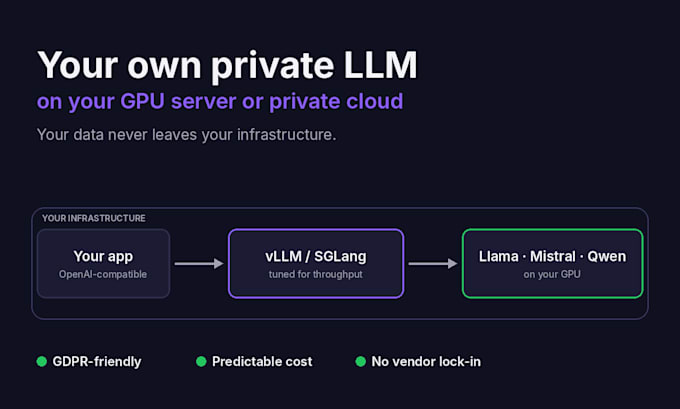
¿Quieres un AI al nivel de ChatGPT sin enviar tus datos a OpenAI? Desplegaré un LLM de código abierto en tu propio servidor GPU o nube privada, de modo que los prompts y documentos nunca salgan de tu infraestructura.
Soy un ingeniero de IA que creó y gestionó una plataforma de IA soberana en producción para una empresa de hosting holandesa con más de 1,4 millones de suscripciones. Esto es ingeniería de inferencia real, no una simple instalación con un clic de Ollama.
Lo que hago:
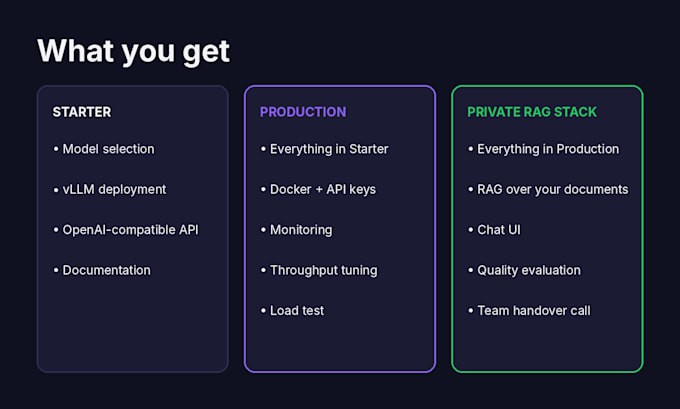
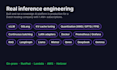
Elegir el modelo adecuado para tu tarea y tu hardware (Llama, Mistral, Qwen, DeepSeek, Gemma)
Despliegue con vLLM o SGLang detrás de una API compatible con OpenAI, para que tu código existente funcione sin cambios
Ajustar el rendimiento, la latencia y la memoria de GPU (cuantización, caché KV, agrupación)
Añadir Docker, claves API, monitoreo y pruebas de carga para tráfico real
Opcional: RAG sobre tus propios documentos con una interfaz de chat
Buen ajuste si:
Tienes requisitos de privacidad, GDPR o cumplimiento
Pagas demasiado por tokens de API y quieres costos previsibles
Ya tienes GPUs (on-prem, RunPod, Lambda, AWS, Hetzner) o necesitas ayuda para elegirlas
Por favor envíame un mensaje antes de hacer el pedido con tu caso de uso y tu hardware, para confirmar el paquete correcto.
Senior AIML Engineer
Idiomas
Traducción automática
Traducción automática
¿Necesito mi propia GPU?
Necesitas acceso a un servidor GPU: on-prem o alquilado a proveedores como RunPod, Lambda, AWS o Hetzner. Si aún no tienes uno, te recomendaré la GPU adecuada y el proveedor para tu modelo y presupuesto antes de que hagas el pedido.
¿Funcionará con mi código actual de OpenAI?
Sí. La implementación expone una API compatible con OpenAI, así que en la mayoría de los casos solo debes cambiar la URL base y el nombre del modelo en tu código.
¿Qué modelo debería usar?
Depende de tu tarea, el idioma y la memoria de GPU. Recomiendo un modelo (p. ej. Llama, Mistral, Qwen, DeepSeek o Gemma) y un nivel de cuantización para obtener la mejor calidad que tu hardware pueda ejecutar rápido.
¿Cómo accedo a mi servidor?
A través de un usuario SSH temporal o una cuenta en la nube con solo los permisos necesarios. Puedes quitar mi acceso en cuanto se entregue el trabajo.
¿Será un modelo autohospedado tan bueno como GPT-4?
Para tareas enfocadas como preguntas y respuestas sobre documentos, resúmenes o clasificación, los modelos abiertos modernos suelen ser lo suficientemente cercanos. Para razonamiento amplio pueden quedarse atrás. Te diré con honestidad qué esperar para tu caso de uso antes de empezar.