Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
Deja de depender de chatbots de IA que alucinan. Para obtener un valor real para tu negocio de los modelos de lenguaje grande, necesitan entender TUS datos.
Diseño agentes de IA personalizados, de grado productivo y pipelines de Retrieval-Augmented Generation (RAG) que se integran de forma segura con tu base de conocimiento empresarial propietaria.
Como Ingeniero Principal de IA/ML, me especializo en llevar la IA de cuadernos experimentales a aplicaciones de software altamente escalables. En implementaciones comerciales previas, mis arquitecturas personalizadas de LLM aumentaron la participación de los usuarios en un 40%.
Lo que libero:
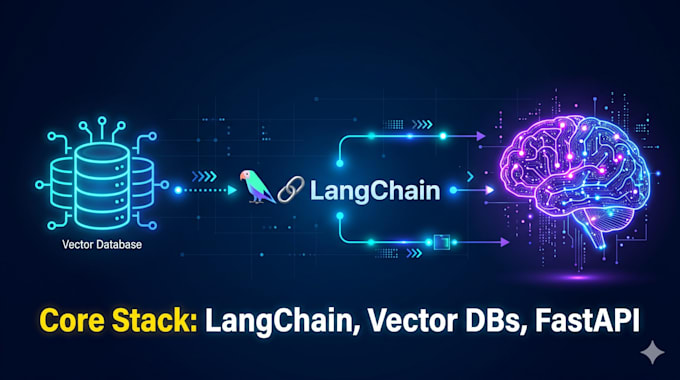
Pila: Python, LangChain, OpenAI, FastAPI, Vector DBs, AWS.
Envíame un mensaje con tus objetivos y ¡empecemos!
Generative AI, RAG, and Edge Computing Expert
Idiomas
Traducción automática
Traducción automática
¿Mi data propietaria es segura? ¿Se usará para entrenar modelos públicos?
Sí, tus datos son completamente seguros. Construyo pipelines RAG usando APIs de nivel empresarial y bases de datos vectoriales dedicadas. Tus documentos se utilizan únicamente para la recuperación de contexto y nunca se usan para entrenar modelos base como GPT de OpenAI.
¿En qué se diferencia esto de usar solo ChatGPT estándar?
Los modelos LLM estándar suelen alucinar hechos y no conocen tus operaciones internas. Un pipeline RAG personalizado restringe a la IA a extraer respuestas solo de los documentos o bases de datos que proporciones, asegurando respuestas muy precisas y verídicas.
¿Qué tipos de datos o documentos puede procesar el agente de IA?
Puedo integrar una amplia variedad de fuentes de datos, incluidos PDFs, archivos CSV/Excel, bases de datos SQL, documentos de Word y wikis internos como Notion o Confluence.
¿Qué stack tecnológico usas para construir el backend?
Arquitecto estos sistemas con Python, LangChain y LangGraph para los flujos de IA. Para la infraestructura del backend uso FastAPI y Redis para garantizar que la app soporte alto tráfico (30+ RPS) con baja latencia, contenedorizado con Docker.
¿Ayudas a desplegar el agente en la nube?
Sí. Si eliges el paquete Premium Enterprise, te entrego una configuración de Docker completamente contenedorizada y de despliegue. Estará lista para alojarse en tu proveedor de nube preferido, como AWS, GCP o Azure.