Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de Inteligencia de Negocios
Las organizaciones pueden tener dificultades con datos desordenados y aislados en diferentes sistemas. En mi trabajo diario, me encargo de cerrar esa brecha, diseñar la capa analítica de la empresa y gestionarla de principio a fin. Espero poder ayudar a empresas más pequeñas o a personas independientes a lograr lo mismo.
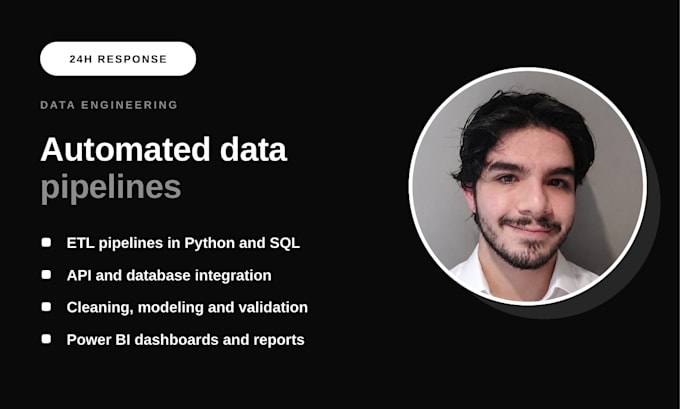
Lo que ofrezco:
Pila tecnológica: Python, SQL avanzado, PySpark, dbt, Databricks, Microsoft Fabric, AWS, Power BI.
Cuéntame qué quieres lograr y desde ahí podemos trabajar juntos.
Tecnología:
Python
•
SQL
Traducción automática
¿Qué necesitas de mí para empezar?
Accede o solicita archivos de muestra de tus fuentes, y una descripción de lo que quieres ver al final. Si es una API, credenciales o documentación. Confirmaré el alcance antes de que hagas el pedido.
¿Esto se ejecutará automáticamente después de que entregues?
En Standard y Premium, sí — obtienes un script de actualización programada y documentación de configuración. Basic es una extracción limpia única.
¿Obtengo el código fuente?
Incluido en Standard y Premium. Disponible como extra en Basic.
Mis datos son desordenados e inconsistentes entre sistemas. ¿Es eso un problema?
No, ese es el caso normal. La resolución de entidades entre sistemas donde los identificadores no coinciden es una parte rutinaria del trabajo.
