Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
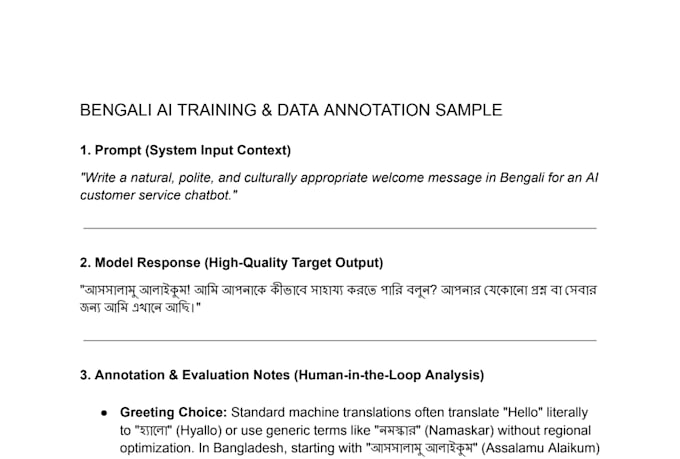
¿Buscas un hablante nativo de bengalí para ajustar, anotar o evaluar datasets para tus modelos de LLM y AI? ¡Estás en el lugar correcto!
Los modelos de AI son tan buenos como los datos en los que se entrenan. Traducciones malas, sintaxis poco natural y errores culturales pueden arruinar el rendimiento de tu modelo. Como hablante nativo de bengalí con un profundo entendimiento de las sutilezas lingüísticas, ofrezco servicios de datos de alta calidad para que tu AI sea fluida, natural y culturalmente precisa.
Lo que puedo hacer por tu proyecto de AI:
¿Por qué elegirme?


Técnica:
Manual
Tipo de etiquetado:
Texto
•
Imagen
•
Audio
Traducción automática
¿Puedes trabajar con plataformas específicas de anotación de datos como Labelbox, Scale AI o interfaces personalizadas?
Sí, por supuesto. Tengo un alto conocimiento técnico y puedo adaptarme fácilmente a cualquier plataforma de terceros o herramienta propietaria que use tu empresa. Solo necesitas agregarme a tu espacio de trabajo por correo electrónico o compartir las credenciales del proyecto, y seguiré estrictamente tus directrices.
¿Cómo garantizas la calidad y precisión de los datos de entrenamiento en bengalí?
Como hablante nativo de bengalí, reviso manualmente cada dato. Me enfoco mucho en la precisión contextual, la sintaxis natural y la alineación adecuada de sentimientos. Nunca uso herramientas automatizadas, bots o traductores automáticos en mi trabajo, asegurando datos de alta calidad para tu LLM.
¿Firmas Acuerdos de Confidencialidad (NDAs) para datasets sensibles o propietarios?
Sí, entiendo que los datasets de entrenamiento son propiedad intelectual valiosa. Trato toda la información del cliente con el máximo nivel de confidencialidad. Si tu equipo requiere firmar un NDA antes de compartir acceso a los datos, estoy completamente dispuesto a revisarlo y firmarlo.
¿Puedes manejar proyectos de datasets a gran escala o contratos a largo plazo?
¡Claro! Aunque mis niveles de paquete cubren cantidades específicas, puedo manejar volúmenes mucho mayores mediante hitos personalizados. Para proyectos continuos o datasets masivos, envíame un mensaje con tus requisitos, directrices y plazo para crear una oferta personalizada adaptada a ti.