Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Analista de datos y científico de datos
Construyo modelos de clasificación, regresión y agrupamiento para datos tabulares en Python. R está disponible por acuerdo.
Incluye: análisis exploratorio de datos (EDA), limpieza y preprocesamiento acordados, entrenamiento del modelo, evaluación y optimización. Recibes código comentado, documentación y explicaciones claras de los resultados y limitaciones.
Cada paquete cubre 1 tabla y 1 objetivo de predicción o pregunta de clustering:
Las columnas de entrada se cuentan antes de la codificación; la columna objetivo es adicional cuando aplica. Tus datos no necesitan estar preparados para el modelo.
Formatos: CSV, Excel o SPSS (.sav).
Envíame un mensaje antes de pedir con tu objetivo, formato de archivo, dimensiones y una muestra anonimizadas. Confirmamos la viabilidad y el alcance del preprocesamiento primero. La fusión de tablas, la reconstrucción manual de datos y la extracción de bases de datos requieren una cotización por separado.
Ejemplo de portafolio: LearnerCue
https://tonywillert.github.io/Portfolio/#learnercue


Lenguaje de programación:
Python
•
R
•
SQL
•
NoSQL
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Herramientas:
Jupyter Notebook
•
TensorFlow
•
Excel
•
RStudio
Traducción automática
¿Qué tareas de machine learning ofreces?
Construyo modelos de clasificación, regresión y clustering para datos estructurados y tabulares. Los objetivos típicos incluyen predecir un resultado, estimar un valor o identificar grupos. Cada pedido cubre un objetivo de predicción acordado o una pregunta de clustering.
¿Mi datos necesitan limpieza primero?
No. Tus datos deben ser una tabla estructurada, pero no necesitan estar listos para el modelo. El EDA y el preprocesamiento acordado están incluidos dentro de los límites del paquete, como limpieza, manejo de valores faltantes, codificación de categorías y escalamiento de características.
¿Cómo se cuentan los límites del paquete?
Cada paquete cubre una tabla. Límites: Básico 2.000 filas/10 columnas de entrada; Estándar 10.000/20; Premium 30.000/30. Cabeceras no cuentan como filas. Las columnas de entrada se cuentan antes de la codificación; una columna objetivo es adicional cuando se necesita.
¿Qué recibiré con cada paquete?
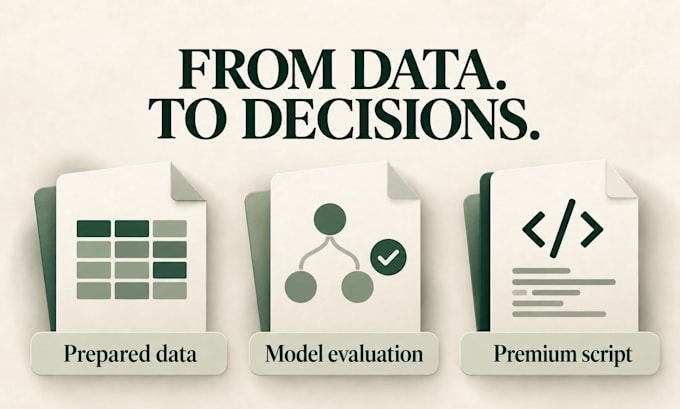
Todos los paquetes incluyen código comentado, resultados de evaluación y documentación. El básico cubre un algoritmo; Estándar y Premium hasta tres. Premium añade un script de predicción reutilizable y una guía para datos con la misma estructura. Los ajustes repetidos durante la afinación cuentan como el mismo algoritmo.
¿Qué formatos de archivo y qué idiomas soportas?
Acepto CSV, Excel (.xlsx) y SPSS (.sav). Python es la opción por defecto; R está disponible por acuerdo. Un diccionario de datos es útil. La extracción de bases de datos, la fusión de tablas y la reconstrucción manual de datos requieren un alcance y cotización separados antes de ordenar.
¿Puedes garantizar una precisión específica?
No se garantiza una puntuación o resultado empresarial específica. El rendimiento depende de la calidad de los datos, la información disponible y la tarea. Evaluamos la viabilidad antes de ordenar. Utilizo validación apropiada y explico el rendimiento medido y sus limitaciones.
¿Qué incluye una revisión?
Una revisión es una ronda consolidada de ajustes dentro del alcance acordado. Básico y Estándar incluyen una; Premium incluye dos. Nuevos análisis, conjuntos de datos, objetivos o entregables requieren una cotización aparte. Se corrigen errores en la implementación del trabajo acordado.
¿Incluyen despliegue y mantenimiento continuo?
Los paquetes cubren el desarrollo del modelo y la entrega. El despliegue en la nube, la integración de API, ejecuciones programadas, supervisión y mantenimiento continuos quedan fuera del alcance. El ajuste fino de modelos preentrenados también es separate. Por favor, discute estos requisitos antes de ordenar.
¿Qué debo enviar antes de realizar el pedido?
Envíanos tu objetivo, formato de archivo, conteos de filas y columnas, descripciones de columnas y una muestra sintética pequeña o completamente anonima que puedas compartir. Confirmamos la viabilidad, las necesidades de preparación, los archivos adecuados y el método de transferencia antes de empezar el trabajo.