Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador senior de Python, ingeniería inversa en Android, agentes de IA y RAG
Construyo scrapers en Python que siguen funcionando en sitios que bloquean bots. Para sitios con mucho JavaScript o protegidos, uso Playwright para manejar un navegador real. Para páginas simples, utilizo herramientas más rápidas como requests y curl_cffi. De cualquier forma, obtienes datos confiables, no un script que deje de funcionar la próxima semana.
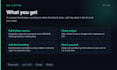
He entregado scrapers para bolsas de trabajo, catálogos de productos de comercio electrónico y grandes archivos de periódicos, entregando resultados en CSV, JSON, Excel o bases de datos, verificando cada campo con la página en vivo. Manejo paginación, inicios de sesión, contenido dinámico y sistemas anti-bot como Cloudflare, Turnstile y PerimeterX con rotación de proxy y lógica de reintentos.
Recibes el código fuente completo, documentación y instrucciones para desplegar o programar, para que puedas volver a ejecutarlo tú mismo. También desarrollé una herramienta que evalúa un sitio en 28 factores para escoger el método de scraping adecuado, así adapto el enfoque a tu objetivo en lugar de usar una sola herramienta.
Indícame el sitio y los campos que necesitas antes de ordenar y te diré qué es posible y el precio.
Tecnología:
Python
•
scrapy
•
Beautiful Soup
•
Playwright
Técnica:
Automatizado
Traducción automática
¿Con qué herramientas construyes los scrapers?
Principalmente con Python. Playwright para sitios con mucho JavaScript o protegidos, requests o curl_cffi con BeautifulSoup para scraping estático rápido, Scrapy para rastreos grandes. Elijo según el objetivo, no una pila fija.
¿En qué plazo lo recibiré?
Un sitio estático suele tomar de 2 a 3 días. Sitios dinámicos con anti-bot toman de 4 a 7 días, dependiendo de las páginas y campos. Te doy una estimación firme después de ver el sitio, antes de que hagas el pedido.
¿Obtengo el código fuente?
Sí. Cada pedido incluye el código fuente completo en Python, un README y comentarios. Puedes ejecutarlo, modificarlo o entregarlo a tu propio desarrollador. Nada está bloqueado u ofuscado.
¿Puedes manejar sitios con protección anti-bot fuerte?
Generalmente sí. Trabajo con Cloudflare, Turnstile y PerimeterX usando rotación de proxy, automatización con navegador real y lógica de reintentos. Algunos objetivos son más difíciles que otros, así que primero verifico el tuyo y te digo la verdad antes de que pagues.
¿Qué pasa con los datos que cargan con JavaScript?
Para eso sirve Playwright. Maneja un navegador real, espera a que cargue el contenido, gestiona inicios de sesión, clics y scroll infinito, y luego extrae lo que la página muestra realmente.
¿Qué formatos entregas?
CSV, JSON, Excel o directamente en una base de datos. En un scrapeo reciente de catálogo, cada campo fue verificado contra la página en vivo para que las columnas coincidan y nada se distorsione. Dime qué formato necesitas.
¿Puede ejecutarse en un horario, no solo una vez?
Sí. Diariamente o cada hora, eliminando duplicados de lo ya obtenido, agregando nuevas filas en un archivo, hoja, base de datos o API. Incluyo instrucciones para que puedas ejecutarlo en tu máquina o servidor.
¿Qué pasa si el scraper pierde datos o necesita cambios?
Incluyo revisiones y pruebo contra el sitio en vivo antes de entregar. Si el sitio cambia su diseño después, te digo cuánto toma arreglarlo. Los pequeños ajustes después de la entrega suelen ser rápidos.
¿Cómo empezamos?
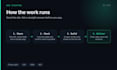
Envía la URL del sitio y los campos exactos que quieres, además de una página de ejemplo si tienes. Confirmaré que se puede scrapear, recomendaré un paquete y te daré un plazo. Luego haces el pedido.


