Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Estados Unidos
Automatización de negocios y ETL de datos con AI en Euda Lab
Deja de reconstruir la misma hoja de cálculo o mover datos manualmente entre sistemas.
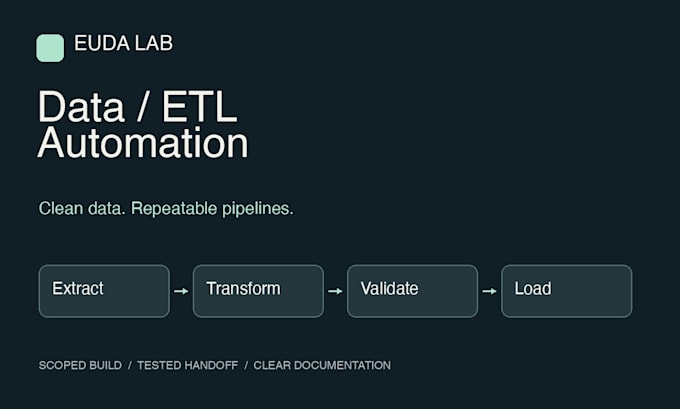
Euda Lab crea sistemas operativos inteligentes que reemplazan el trabajo repetitivo de conocimiento. Este servicio extrae datos estructurados, los transforma en un formato coherente, los valida y los carga en tu destino acordado.
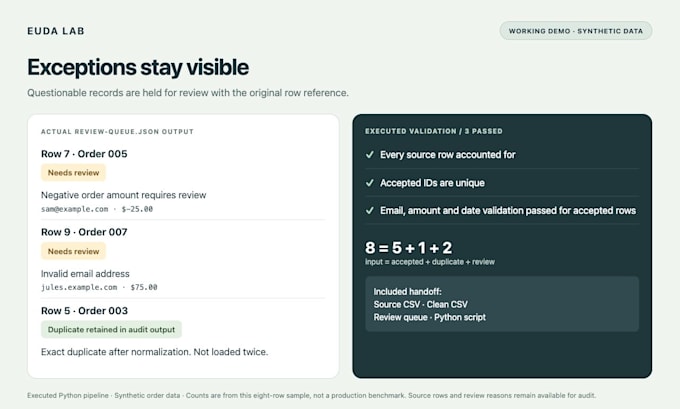
Las fuentes pueden incluir archivos CSV, hojas de cálculo, APIs documentadas y bases de datos SQL. Acordamos los mapeos de campos, reglas de limpieza, manejo de duplicados, volumen y verificaciones de aceptación antes del desarrollo.
Recibirás código fuente en Python, instrucciones de configuración, pruebas de validación y resultados, y un runbook. La opción estándar incluye lotes programados; la opción premium añade cargas incrementales soportadas y alertas de fallos en un entorno acordado. Los conteos de connector incluyen conexiones a la fuente y al destino.
Envíame un mensaje en Fiverr con tus sistemas, muestras anónimas y frecuencia de actualización antes de ordenar. Una fuente es una estructura de archivo, recurso API o tabla de base de datos. El hosting y servicios pagos son separados. La extracción de PDF/OCR, sistemas no documentados, streaming en tiempo real, grandes backfills y mantenimiento continuo requieren un alcance separado. Las revisiones perfeccionan los mapeos y reglas acordados; los nuevos requisitos se escogen por separado.
Plataforma de destino:
Otros
Herramientas y plataformas:
Otros
Traducción automática
¿Qué se considera una fuente o conector?
Una fuente es una estructura de archivo acordada, recurso API o tabla de base de datos. Los conteos de connector incluyen entradas y el destino. Confirmamos los campos, volumen, historial y frecuencia de actualización antes de ordenar.
¿Incluyen hosting y soporte continuo?
El hosting y los servicios pagos son separados. Los paquetes incluyen código fuente, documentación y revisiones listadas. La monitorización continua, mantenimiento y nuevas funciones requieren un acuerdo separado.
¿Puedes procesar PDFs o datos en tiempo real?
Esta lista cubre pipelines estructurados por lotes. La extracción PDF/OCR, sistemas no documentados, streaming en tiempo real y grandes backfills históricos requieren un alcance separado. Envía muestras anónimas para que podamos evaluar el trabajo.