Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de datos de Azure Databricks y PySpark
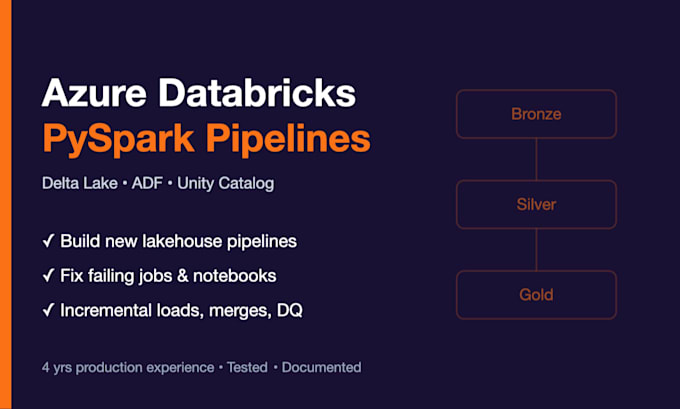
¿Necesitas un pipeline confiable en Azure Databricks o uno que siga fallando? Soy Ingeniero de datos en Azure con unos 4 años construyendo pipelines de lakehouse en producción con Databricks, PySpark, Azure Data Factory, Delta Lake y Unity Catalog.
Lo que hago:
Cómo trabajamos: comparte tu notebook o código y datos de muestra (los datos de prueba sirven), o dame acceso mínimo al workspace a través de tu admin. Por favor, nunca envíes contraseñas o llaves.
Utilizo herramientas asistidas por IA, y cada entrega está probada y documentada por mí.
Por favor, envíame un mensaje antes de ordenar para confirmar alcance y timeline.

Herramientas y plataformas:
Azure Data Factory
Traducción automática
¿Necesitas mi contraseña de Azure o Databricks?
No. Comparte código y datos de muestra, o haz que tu admin me dé un usuario de mínimo privilegio en tu workspace. Nunca comparto contraseñas ni llaves.
¿Puedes trabajar en AWS o GCP en lugar de Azure?
Sí, para Databricks y PySpark en cualquier nube. Mi experiencia más profunda es Azure, así que por favor envíame un mensaje primero con tu configuración.
