Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Level 2
Traducción automática
Enviar datos empresariales sensibles a servidores de IA públicos es un riesgo serio para la privacidad y los costos mensuales de API se acumulan rápidamente.
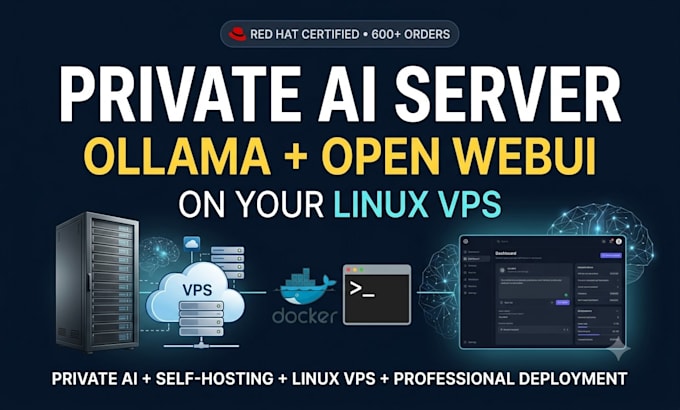
Desplegaré un chatbot de IA completamente privado y auto hospedado en tu VPS Linux usando Ollama + Open WebUI, brindando a tu equipo una experiencia segura similar a ChatGPT sin costos recurrentes.
Como ingeniero certificado por Red Hat (RHCSA/RHCE, más de 14 años, más de 600 pedidos), no solo lo instalo; también lo aseguro para que no quede expuesto en línea.
Lo que haré:
Instalar y configurar Docker, Ollama y Open WebUI
Desplegar LLMs de código abierto (Llama 3, Mistral, DeepSeek, Qwen)
Configurar proxy inverso Nginx con SSL (HTTPS)
Habilitar transmisión de tokens en tiempo real
Configurar panel de administración, autenticación de usuarios y acceso multiusuario
Incluir firewall y endurecimiento básico del servidor
Configurar RAG para consultas en PDF/documentos (Estándar y Premium)
Documentación completa de la configuración
Por qué este servicio:
100% privado tus datos nunca salen de tu servidor
Sin costos de API, sin límites de tokens
Listo para producción, estable y seguro
Funciona en cualquier VPS: DigitalOcean, Hetzner, Vultr, Contabo, AWS, Linode. Soporta GPU y solo CPU.
Nota: el rendimiento del modelo depende de tu CPU/RAM/GPU.
Contáctame antes de ordenar para confirmar tus especificaciones y objetivos.
Linux Server Security Expert cPanel WHM Cloudflare Docker RHCSA RHCE
Level 2
Idiomas
Traducción automática
Traducción automática
¿Cuáles son los requisitos mínimos del servidor?
Para modelos ligeros como Llama 3.2 (3B) o Mistral, necesitas al menos 4GB de RAM y 2 núcleos de CPU. Para modelos más grandes (8B+), recomiendo 8GB–16GB de RAM. ¿No estás seguro de tus especificaciones? Compárteme antes de ordenar y te recomendaré el mejor modelo para tu hardware.
¿Mis datos son realmente privados?
100% sí. Esto funciona completamente en tu propio servidor — tus chats, documentos y datos nunca salen de tu máquina. No hay llamadas a API a OpenAI ni a terceros. Privacidad total por diseño.
¿Necesito una clave API de OpenAI o suscripción?
No. Esta configuración usa modelos gratuitos y de código abierto a través de Ollama. Una vez desplegado, puedes usar la IA sin límites — sin tarifas por token, sin costos mensuales, sin claves API nunca.
¿Puede esto funcionar sin GPU?
Por supuesto. Me especializo en optimizar modelos para entornos VPS solo con CPU usando cuantización de 4 bits. Una GPU proporciona respuestas más rápidas, pero los CPUs modernos manejan tareas diarias sorprendentemente bien.
¿Puede mi equipo usar esto juntos?
Sí. Los paquetes Estándar y Premium incluyen autenticación multiusuario. Tendrás un panel de administración para crear cuentas, gestionar accesos y controlar quién usa la plataforma.
¿Qué es RAG y lo necesito?
RAG (Retrieval-Augmented Generation) permite que tu IA responda preguntas usando tus propios documentos privados — PDFs, archivos Word, archivos de texto. Sube un documento y pregunta lo que quieras sobre él. Incluido en los paquetes Estándar y Premium.
¿Qué distribución de Linux recomiendas?
Se recomienda encarecidamente Ubuntu 22.04 LTS o 24.04 LTS para mayor estabilidad y compatibilidad. También puedo trabajar con Debian, CentOS o AlmaLinux si es necesario.
¿Qué pasa si mi VPS no tiene suficiente RAM para el modelo que quiero?
Revisaré las especificaciones de tu servidor después de que hagas el pedido. Si tu hardware no soporta el modelo preferido, te recomendaré la mejor alternativa y confirmaré contigo antes de continuar — sin sorpresas.
¿El servidor de IA seguirá funcionando después de que termines?
Sí. Todo está configurado como un servicio persistente de Docker que se inicia automáticamente al reiniciar. Tu servidor de IA funciona 24/7 sin intervención manual.
