Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr


Traducción automática
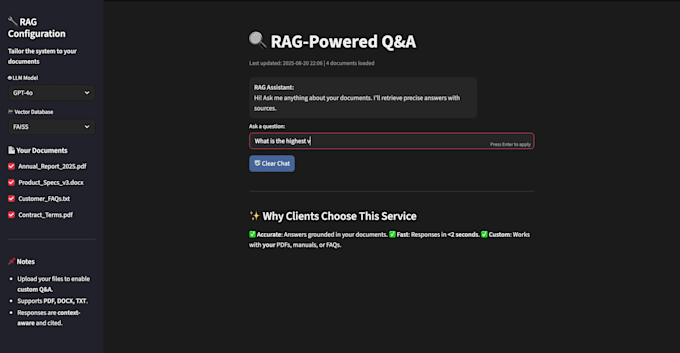
¿Buscas potenciar tus aplicaciones de IA con Retrieval-Augmented Generation (RAG)? ¡Estás en el lugar correcto!
Diseñaré e implementaré un pipeline de RAG listo para producción que combina el poder de Large Language Models (LLMs) con sistemas de recuperación inteligentes, permitiendo que tu IA proporcione respuestas precisas, contextuales y actualizadas.
Lo que ofrezco:
Desarrollo completo de pipeline RAG (recuperador + generador)
Integración con bases de datos vectoriales (Pinecone, Weaviate, FAISS, Milvus, etc.)
Ingesta y segmentación de documentos con embeddings
Despliegue listo para API (FastAPI/Flask)
Fine-tuning para casos de uso específicos del dominio
Integración de AI explicable para mayor transparencia
Optimización para escalabilidad y latencia
Casos de uso:
¿Por qué elegirme?
Como ingeniero experto en ML/AI y desarrollador en Python, he creado soluciones RAG reales que son escalables, flexibles y adaptadas a las necesidades del negocio. Aseguro código limpio, documentado y listo para producción para que puedas escalar con confianza.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Idiomas
Traducción automática
Traducción automática
¿Qué es una solución RAG?
Una solución RAG (Retrieval-Augmented Generation) combina un recuperador (que obtiene conocimientos relevantes de una base de datos) con un generador (como GPT) para ofrecer respuestas precisas, contextuales y confiables.
¿Por qué necesito RAG en lugar de un LLM normal?
Los LLMs estándar pueden inventar o dar respuestas desactualizadas. Con RAG, tu IA tiene acceso a conocimientos en tiempo real y específicos del dominio, asegurando precisión, confiabilidad y menos inventos.
¿Qué bases de datos vectoriales soportas?
Soporto Pinecone, Weaviate, FAISS, Milvus, Chroma y ElasticSearch. Si tienes otro en mente, también puedo integrarlo.
¿Puedes desplegar la solución en producción?
¡Sí! Puedo desplegar tu pipeline RAG como una API (FastAPI/Flask), integrarla en chatbots o aplicaciones web, y configurarla para escalabilidad en entornos cloud (AWS, GCP, Azure, etc.) (Solo plan específico).
¿Necesito mi propio LLM o podemos usar OpenAI u otros?
¡Ambas opciones son posibles! Puedo integrar modelos de OpenAI, Anthropic, Cohere, HuggingFace o tu propio LLM ajustado según tus necesidades.
¿Puedes hacerla específica para un dominio (legal, médico, financiero, etc.)?
Por supuesto ✅. Puedo ajustar embeddings, lógica de recuperación y configuración del pipeline para aplicaciones específicas del dominio, asegurando que tu solución RAG se adapte a tu industria.
¿Cómo se garantiza la privacidad y seguridad de los datos?
Utilizo pipelines seguros, almacenes de vectores privados y APIs con control de acceso para proteger tus datos sensibles. El despliegue puede hacerse en tus servidores o cuentas en la nube para control total.
¿Qué necesito para empezar?
Solo comparte tus requisitos, datos disponibles (documentos, base de conocimientos, etc.) y tecnología preferida. ¡Te guiaré en todo el proceso!