Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de IA, LLM, RAG y NLP
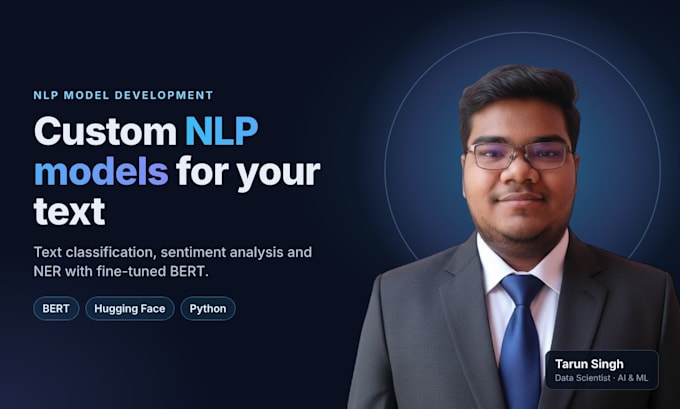
¿Necesitas un modelo que entienda tu texto: reseñas, tickets de soporte, correos, comentarios o documentos?
Construyo y ajusto modelos NLP con BERT, RoBERTa y DistilBERT que convierten texto sin procesar en predicciones precisas.
Qué puedo construir:
Lo que obtendrás:
¿Por qué yo?
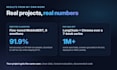
Soy Data Scientist trabajando en NLP y LLMs todos los días. Afiné MobileBERT a 91.9% de precisión en la detección de emociones de 6 clases, luego reduje su tamaño a la mitad con cuantización manteniendo 91.1%. En mi trabajo, armo pipelines LangChain LLM y servicios FastAPI que corren en producción.
Envíame un mensaje con tus datos y tu objetivo antes de ordenar, y te sugiero el paquete adecuado.
Lenguaje de programación:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Herramientas:
Jupyter Notebook
•
TensorFlow
•
Excel
•
MLflow
•
Colab
Traducción automática
¿Qué datos debo proporcionar?
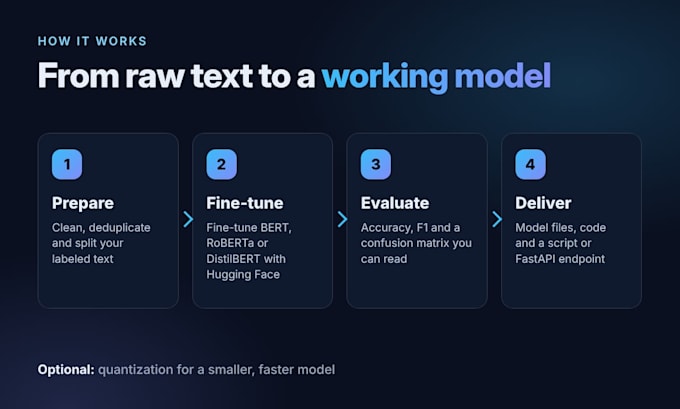
Un archivo CSV o Excel con tu texto y etiquetas funciona mejor. ¿Aún sin etiquetas? Puedo sugerir un plan de etiquetado o usar métodos de zero-shot y basados en LLM para empezar.
¿Qué modelos utilizas?
BERT, RoBERTa, DistilBERT o MobileBERT, y LLMs de código abierto como Llama o Mistral a través de Hugging Face. Elijo el modelo más pequeño que cumpla tus necesidades de precisión y velocidad.
¿Puedes garantizar una precisión específica?
Nadie puede prometer precisión con certeza antes de ver los datos. Comparto una línea base desde el inicio, explico los resultados con claridad y mejoro el modelo en las revisiones de tu paquete.
¿Podré ejecutar el modelo por mi cuenta?
Sí. Obtienes los archivos del modelo entrenado, el código y un script de inferencia sencillo. La opción Standard añade un endpoint FastAPI, y la Premium añade Docker y despliegue en la nube.
¿Trabajan con idiomas distintos al inglés?
Sí. Uso modelos multilingües como XLM-RoBERTa y mBERT, incluyendo hindi y otros idiomas de la India.
¿Mis datos se mantienen privados?
Tus datos se usan solo para tu proyecto y nunca se comparten. Elimino mis copias después de la entrega si así lo pides.