Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr


Traducción automática
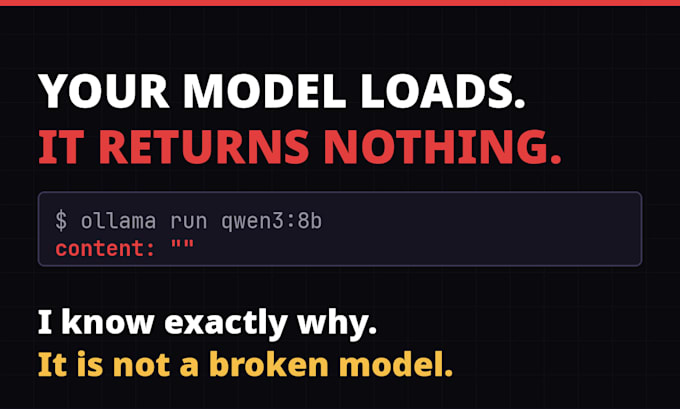
Tu modelo carga pero no devuelve nada. O funciona a 2 tokens por segundo en una GPU que debería dar cuarenta. O Open WebUI tarda para conectarse a Ollama y nunca conecta. Yo arreglo esto.
Ejecuto una pila de IA local en una sola 3090: Ollama, Open WebUI, ComfyUI, entrenamiento LoRA, pipelines automatizados. He pasado por todo esto yo mismo y he descubierto por qué.
Qué soluciono:
No necesito acceso remoto. Tú me muestras la salida, te digo qué cambiar y por qué dejó de funcionar.
¿No estás seguro de que valga la pena un arreglo completo? el paquete de 15$ incluye un diagnóstico por escrito. Si es un cambio de cinco minutos, te diré exactamente qué es.
Envíame un mensaje primero con tu sistema operativo, GPU y VRAM. Si no puedo arreglarlo te lo digo, antes que aceptes mi dinero.
Construyo mis propias herramientas de IA locales y las ejecuto a diario. No es teoría.
AI Automation and LLM Integration Developer
Idiomas
Traducción automática
Traducción automática
¿Puedes arreglar esto si estoy en Windows y no en Linux?
Sí. La mayoría de estas fallas son iguales en ambos sistemas: presupuestos de tokens, espacio en VRAM, keep-alive y tamaño del contexto no dependen de tu sistema operativo. Algunas cosas difieren (controladores, WSL, dónde Ollama guarda los modelos) y te diré cuáles aplican a ti.
¿Necesitas acceso remoto a mi máquina?
No, y prefiero no hacerlo. Para la mayoría de los problemas trabajo con tus logs, tu configuración y la salida de un par de comandos de solo lectura que te daré, luego envío la solución con una explicación. Si prefieres hacerlo en vivo, una compartición de pantalla funciona, pero es tu decisión, no un requisito.
¿Qué pasa si no puedo arreglarlo?
Entonces lo digo. Envíame un mensaje antes de ordenar con lo que está pasando y tu hardware, y te diré honestamente si puedo resolverlo. Prefiero rechazar un pedido que cobrar por un problema que no puedo arreglar.
Mi GPU es pequeña o solo uso CPU. ¿Es imposible?
No, pero la respuesta honesta puede ser que el modelo que intentas ejecutar no cabe. Parte de lo que hago es decirte qué funcionará bien en tu hardware, en lugar de hacerte luchar con un modelo que nunca iba a funcionar.
¿Solo me darás un script o entenderé qué salió mal?
Lo entenderás. Cada arreglo viene con qué estaba mal y por qué, porque el mismo tipo de problema vuelve y prefiero que lo reconozcas la próxima vez en lugar de tener que ordenar de nuevo.