Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de aprendizaje automático
¿Necesitas pipelines de datos confiables y escalables para tu negocio?
Construiré soluciones personalizadas de ingeniería de datos para automatizar flujos de trabajo, mejorar la calidad de los datos y optimizar el procesamiento de datos.
Mis servicios incluyen:
Lo que obtienes:
Me enfoco en construir soluciones prácticas adaptadas a tus requisitos y a tu infraestructura existente.
Por favor comparte tus fuentes de datos, salida esperada, volumen de datos y tecnologías preferidas antes de hacer el pedido. Los proyectos complejos pueden requerir una oferta personalizada.
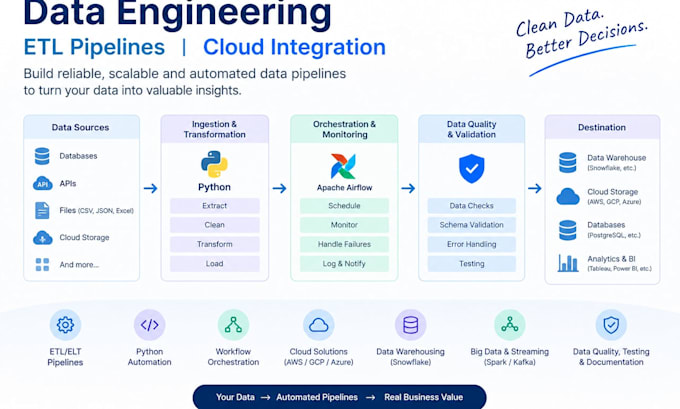
Herramientas y plataformas:
Otros
Traducción automática
¿Qué información necesitas antes de iniciar un proyecto?
Necesito los requisitos de tu proyecto, fuentes de datos, salida esperada, volumen aproximado de datos, frecuencia de procesamiento y herramientas o plataforma en la nube preferidas. Datos de muestra o datos anonimizados y código existente son útiles cuando sea aplicable.
¿Qué tecnologías y plataformas soportas?
Trabajo con Python, SQL, flujos de trabajo ETL/ELT, Apache Airflow y orquestadores similares, Apache Spark, Kafka, Snowflake, Databricks y plataformas en la nube como AWS, Google Cloud y Azure. La pila tecnológica exacta depende del alcance del proyecto.
¿Puedes trabajar con mi pipeline de datos o código existente?
Sí. Puedo ayudar a solucionar problemas, modificar, optimizar o ampliar un pipeline existente. Comparte la arquitectura actual, el código relevante, detalles de errores y el resultado deseado para que pueda evaluar el alcance antes de comenzar el trabajo.
¿Incluyen tus paquetes despliegue en la nube?
El despliegue en la nube solo está incluido cuando se especifica explícitamente en el paquete seleccionado o se compra como extra. Los cargos por uso en la nube, suscripciones de terceros y costos adicionales de infraestructura no están incluidos en el precio de mi servicio.
¿Puedes construir pipelines de streaming de datos en tiempo real?
Sí, para casos de uso claramente definidos. Las integraciones de streaming pueden incluirse en el paquete correspondiente o comprarse como extra. Clusters complejos de Kafka, sistemas de alto rendimiento y configuraciones extensas de infraestructura pueden requerir una oferta personalizada.
¿Qué pasa si mi proyecto requiere más trabajo del que incluye el paquete?
Revisaré tus requisitos y aclararé el alcance antes de comenzar. Si tu proyecto necesita fuentes de datos adicionales, transformaciones complejas, integraciones extras o infraestructura más allá del paquete seleccionado, puedo proponer una oferta personalizada con un precio y plazo de entrega acordados.
