Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
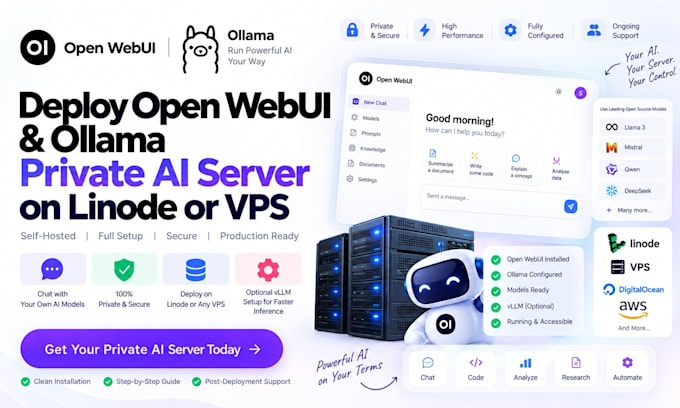
Implementar infraestructura de AI privada autohospedada requiere una configuración precisa del servidor y una integración confiable del software para garantizar una inferencia fluida. Ofrezco configuraciones completas de Open WebUI, Ollama y motores vLLM de alto rendimiento en Linode, DigitalOcean o cualquier VPS dedicado, manteniendo tus datos internos completamente privados.
Mi proceso de despliegue incluye preparación del sistema operativo, aceleración CUDA, orquestación de contenedores mediante Docker y entrega segura de interfaz web. Ya sea que desees modelos locales ligeros con Ollama o procesamiento por lotes continuo y baja latencia impulsado por vLLM, optimizo cada capa según las especificaciones de tu hardware.
Desde configurar la encriptación SSL del dominio hasta gestionar controles de acceso multiusuario, obtienes un centro de control de IA listo para producción, diseñado para equipos, desarrolladores y empresas que requieren máximo rendimiento y control sobre sus LLMs privados.
AI Server Cloud Deployment Specialist
Idiomas
Traducción automática
Traducción automática
¿Por qué debería usar vLLM en lugar de Ollama estándar para servir modelos?
Ollama es ideal para desarrollo simple en escritorio y tareas de un solo usuario, mientras que vLLM utiliza PagedAttention y procesamiento por lotes continuo para ofrecer mayor rendimiento, baja latencia y gestión eficiente de VRAM en GPU al atender múltiples usuarios simultáneamente en producción.
¿Puedo conectar APIs comerciales externas como OpenAI o Anthropic junto con mis modelos vLLM locales?
Sí, Open WebUI soporta conexiones duales de forma nativa. Puedes consultar modelos locales que corren a través de Ollama/vLLM y endpoints de API en la nube externos simultáneamente en el mismo espacio de trabajo de usuario.
¿Cuáles son las especificaciones mínimas de hardware necesarias para ejecutar vLLM y open webui sin problemas en un VPS?
Mientras que Ollama solo con CPU funciona en instancias estándar de VPS, ejecutar vLLM requiere un VPS Linux equipado con una GPU NVIDIA (al menos 16GB de VRAM para modelos de 7B/8B de parámetros) y un mínimo de 16GB de RAM para una inferencia óptima.
