Desplegaré y ajustaré un llm privado auto hospedado en tu propio servidor GPU

S
stchopko
S
stchopko
Stepan C.
Parte de la información se ha traducido automáticamente.

Acerca de este Servicio

Traducción automática

¿Quieres un AI tipo ChatGPT que funcione en tu propio hardware, sin enviar datos a terceros? Lo configuraré y lo haré rápido.


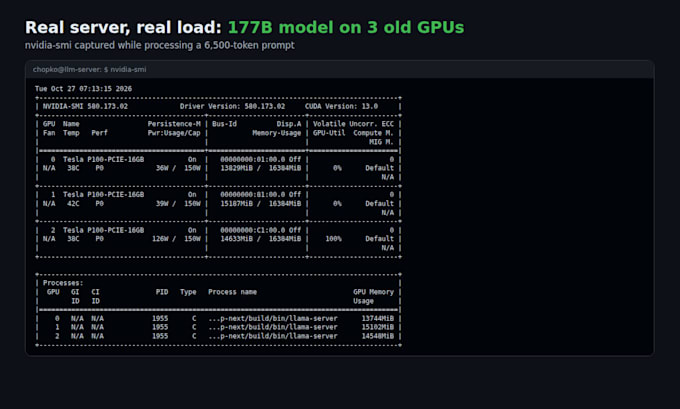
La mayoría de configuraciones solo instalan un runner con ajustes por defecto y dejan 2-3x de rendimiento sobre la mesa. Haré benchmarks y ajustaré para tu GPU y RAM exactas. Resultados reales desde mi propio servidor (Tesla P100 16GB + EPYC):

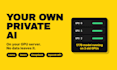
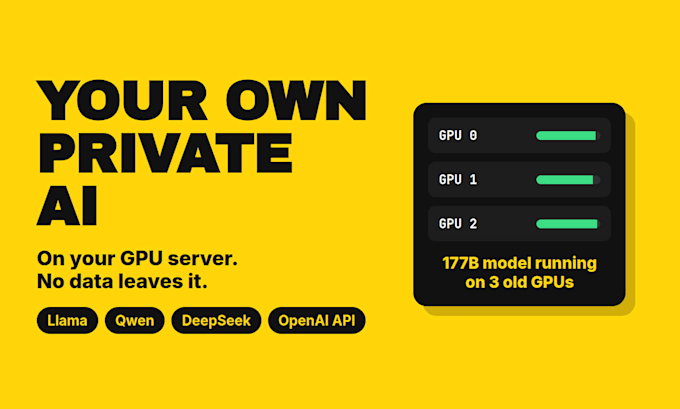
  • Modelo MoE de 177B de parámetros en tres GPU antiguas de 16GB a 13.5 tokens/s
  • Procesamiento de prompts 3.4x más rápido (75 a 254 tokens/s) al ajustar tamaños de lote
  • Modelo de codificación de 80B a 30 tokens/s en dos GPUs más viejas
  • La cuantización adecuada para tu generación de GPU

Qué obtendrás:

  • servidor llama.cpp con API compatible con OpenAI
  • Interfaz de chat web
  • Selección de modelo para tu hardware y caso de uso
  • Servicio de inicio automático y acceso remoto seguro
  • Informe de benchmarks: a qué velocidad llegas y por qué

Envíame tu GPU, RAM y qué quieres que haga la IA, y te diré qué es realista antes de que hagas el pedido.

Conoce a Stepan C.

Stepan C.

PHP Developer and Self Hosted LLM Engineer

  • DeUcrania
  • Miembro desdemay 2021
  • Idiomas

    Ucraniano, Inglés
Backend developer with 9 years of commercial PHP (Symfony, Laravel, legacy code), including 6 years as Senior PHP Developer at an Irish software company, and hands-on experience running large language models on my own hardware. I fix and upgrade PHP sites that broke after a PHP 8.x update, migrate projects to modern Linux servers, and deploy private, self-hosted LLMs that run on your own GPU - no data leaves your server. I don't guess: I find the root cause, fix it, and tell you what was wrong. Clear written communication, fast replies.

Traducción automática

Etiquetas relacionadas