Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Raspado con Python, automatización de datos, especialista en sitios chinos
¿Necesitas una herramienta que convierta PDFs, documentos escaneados, imágenes o texto pegado en datos limpios y estructurados? Desarrollo software de extracción de datos con IA a medida (Python, FastAPI, React) alrededor de tus documentos y tus campos.
LO QUE OBTENDRÁS
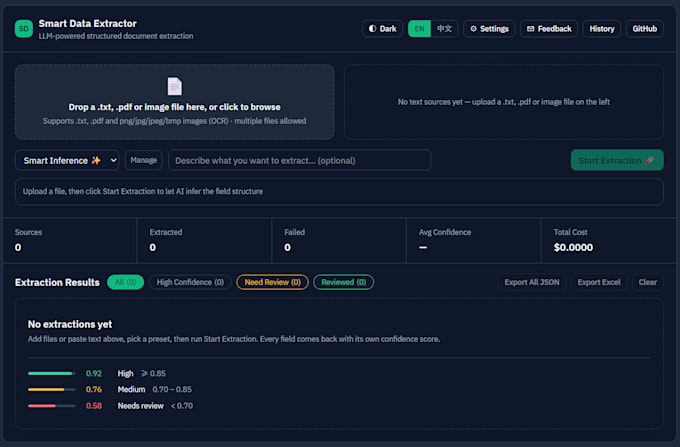
- Una pipeline de extracción usando un LLM y OCR, adaptada a tu esquema (facturas, tarjetas de visita, leads, formularios o cualquier otra cosa)
- Validación de formatos para campos como correo, teléfono, URL y fecha
- Un puntaje de confianza en cada campo. Los valores faltantes quedan en blanco y marcados, nunca inventados
- Exportación JSON/Excel, entregada como CLI, API REST o aplicación web según tu paquete
- Código fuente, pruebas automatizadas y un README
POR QUÉ ESTE ENFOQUE
Muchos demos de extracción con LLM se ven bien hasta que, sin querer, inventan un valor. Yo diseño para evitarlo: validación, señales de confianza del motor OCR y una pantalla de revisión para campos inciertos. No prometo un 100% de precisión, pero los campos incorrectos o ausentes se marcan en lugar de pasar desapercibidos.
Este servicio se basa en un proyecto mío con más de 700 pruebas automatizadas. Se admiten documentos en inglés y chino.
ANTES DE PEDIR
Envíame un mensaje con 3-5 documentos de muestra y los campos que necesitas, para confirmar el alcance y el paquete adecuado.
Tecnología:
Python
