Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Desarrollador de web scraping en Python y automatización de navegadores
¿Necesitas datos limpios y estructurados extraídos de una tienda de comercio electrónico, un directorio empresarial o un sitio con inicio de sesión protegido sin bloques ni filas rotas?
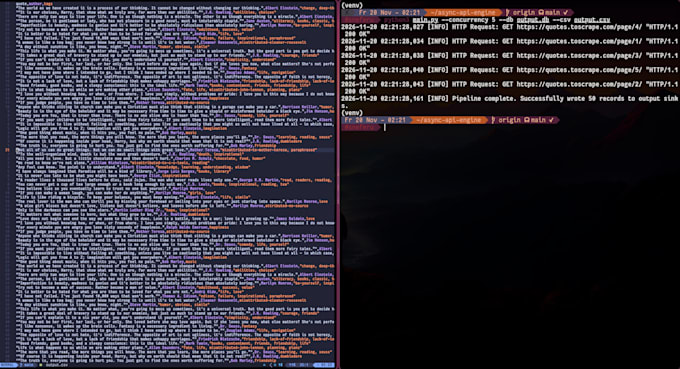
Construyo pipelines de scraping web en Python rápidos y automatizados que entregan juegos de datos validados, deduplicados y listos para usar de inmediato.
Qué puedo rastrear y automatizar para ti:
Tiendas de comercio electrónico y Shopify / WooCommerce: títulos de productos, precios, variantes, SKUs, estado de stock y URLs de imágenes.
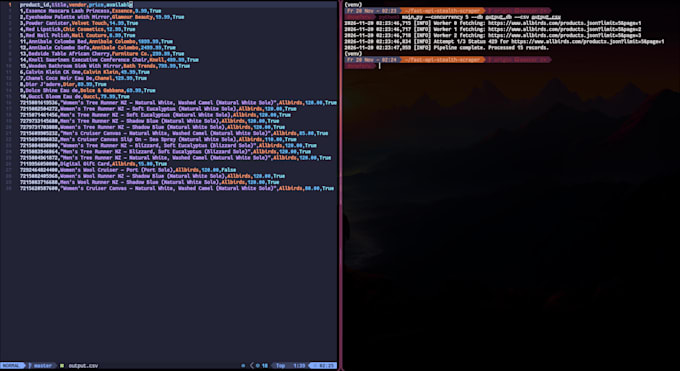
Sitios dinámicos con JavaScript y anti-bots: fingerprinting TLS en modo stealth (curl_cffi) y automatización de navegador Playwright para evitar límites de tasa y renderizado dinámico.
Portales protegidos por inicio de sesión: scraping automatizado de sesiones autenticadas para paneles y directorios de miembros.
Formatos de entrega limpios: CSV, Excel (.xlsx), JSON, JSONL o bases de datos SQLite, más código fuente de Python documentado en pedidos Premium.
¿Por qué elegir este servicio?
Extracción asíncrona a alta velocidad (asyncio, httpx, lxml, Playwright)
Formato de datos limpio, deduplicación y validación de campos incluidos
Vista previa gratuita de muestra de 10 filas antes de que puedas comprometerte con una extracción completa
Envíame la URL objetivo y los campos requeridos antes de pedir para que pueda confirmar la viabilidad y enviarte una muestra.
Traducción automática
¿Puedes enviarme una muestra gratuita antes de hacer el pedido?
¡Sí! Envíame un mensaje con tu URL objetivo y los campos exactos que necesitas. Rastraré una muestra gratuita de 10 filas en CSV o Excel para que verifiques la estructura y la precisión antes de pedir.
¿Puedes rastrear sitios dinámicos con JavaScript o sitios con protección anti-bots?
Sí. Para aplicaciones dinámicas de una sola página, paginación o sitios con límites de tasa y verificación de bots, utilizo la automatización de navegador Playwright y la suplantación de huellas TLS (curl_cffi) para extraer datos de forma fiable.
¿Puedes extraer datos de un sitio que requiere login?
Sí, siempre que tengas acceso autorizado a la cuenta. Con el paquete Premium, construyo una automatización Playwright persistente para extraer datos de dashboards autenticados y portales de miembros.
¿En qué formatos de archivo recibiré mis datos?
Puedo entregar tus datos limpios y deduplicados en CSV, Excel (.xlsx), JSON, JSONL o una base de datos SQLite, el formato que mejor se adapte a tu flujo de trabajo.
¿También recibiré el script del scraper en Python para poder ejecutarlo luego yo mismo?
¡Sí! El código fuente de Python limpio y documentado con instrucciones de configuración viene incluido en el paquete Premium (o está disponible como complemento para pedidos Básico y Estándar).