Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
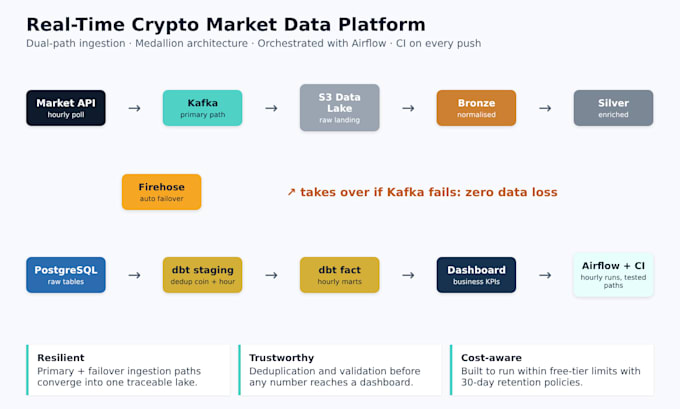
¿Necesitas pipelines de datos confiables que simplemente funcionen? Soy un ingeniero de datos con una maestría en ciencia de datos y experiencia en la industria en Amazon y Tata Consultancy Services, donde construí pipelines que procesan más de 1TB de datos para más de 100 analistas.
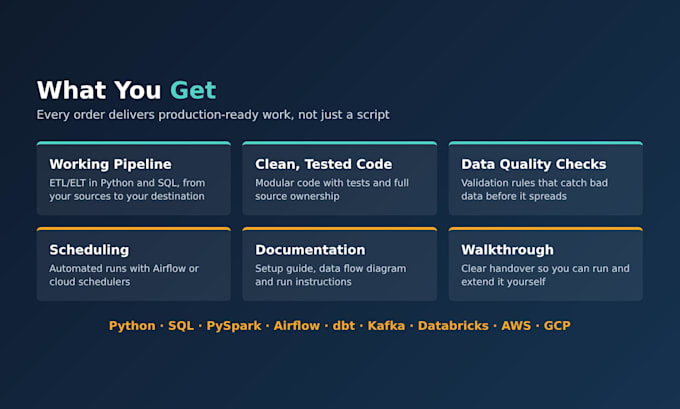
Lo que puedo construir para ti:
Por qué trabajar conmigo:
Cómo funciona:
No estás seguro de qué paquete se ajusta? Envíame un mensaje antes de ordenar y te responderé rápidamente.

Traducción automática
¿Qué necesitas de mí para empezar?
Acceso a o muestras de tus fuentes de datos, el destino final (base de datos, warehouse o archivos), y una breve descripción del resultado esperado. Las credenciales se pueden compartir de forma segura una vez iniciado el pedido.
¿Con qué herramientas y plataformas trabajas?
Python, SQL, PySpark, Apache Airflow, dbt, Kafka y Databricks, en AWS, GCP o PostgreSQL. Si usas un stack diferente, envíame un mensaje primero y confirmaré si puedo ayudarte.
¿Seré dueño del código?
Sí. Recibirás el código fuente completo, documentación e instrucciones de configuración, y es 100% tuyo para usar y modificar.
¿Puedes trabajar con mi pipeline o base de datos existentes?
Sí. Puedo ampliar, arreglar u optimizar pipelines existentes. Comparte los detalles antes de ordenar para que pueda definir el alcance correctamente.
¿Cómo mantienes segura mi información?
Solo uso el acceso necesario para la tarea, nunca comparto ni almaceno tus datos más allá del proyecto, y puedo trabajar con datos de muestra anónimos si lo prefieres.
¿Qué pasa si mi proyecto no encaja en un paquete?
Envíame un mensaje con tus requisitos y crearé una oferta personalizada que se ajuste a tu alcance y presupuesto.