Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
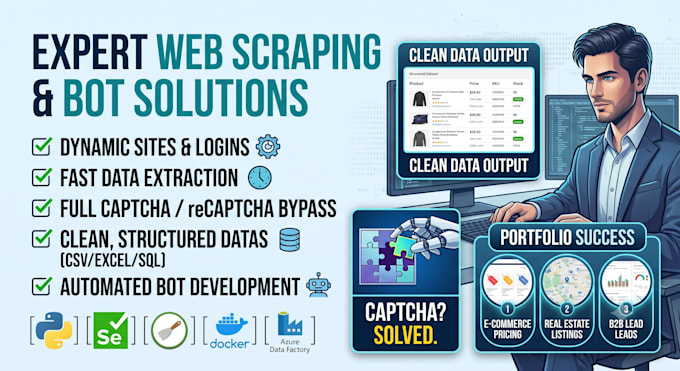
¿Necesitas un bot automatizado de scraping web en Python o extracción de datos a gran escala? Creo scrapers resistentes, rápidos y escalables adaptados a tus necesidades exactas de datos.
Con más de 5 años de experiencia en Data Engineering, extraigo datos de páginas estáticas, sitios dinámicos con JavaScript y portales protegidos por login sin que me bloqueen.
Lo que ofrezco:
Pila tecnológica:
¿Por qué elegirme?
Nota: Por favor, envíame un mensaje con la URL del sitio web objetivo y los campos de datos requeridos antes de ordenar para que pueda probar el sitio y sugerir el mejor paquete.
Senior Data Engineer Web Scraping ETL Pipelines Azure Microsoft Fabric
Idiomas
Traducción automática
Traducción automática
¿Qué necesitas de mí para empezar?
Por favor, proporciona la URL del sitio web objetivo, una lista de campos o columnas específicas que necesitas (por ejemplo, nombre del producto, precio, calificación, URL de la imagen) y tu formato de salida preferido (Excel, CSV, JSON o SQL).
¿Puedes hacer scraping en sitios que requieren login o usan JavaScript pesado?
Sí. Usando Selenium y Playwright, puedo manejar formularios de login, cookies, autenticaciones de múltiples pasos, ventanas modales y feeds de scroll infinito.
¿Cómo manejas los CAPTCHAs y los bloqueos de Cloudflare?
Integro APIs especializadas de resolución de terceros (como 2Captcha, CapSolver o Anti-Captcha) junto con proxies residenciales rotativos y navegadores anti-detect como Playwright/Undetected-Chromedriver para eludir reCAPTCHA, hCaptcha y Turnstile de Cloudflare automáticamente.
¿Puedes automatizar el scraper para que funcione diariamente o semanalmente?
¡Sí! En el paquete Premium, puedo contenerizar el script usando Docker o configurar trabajos cron automáticos o funciones en la nube (AWS Lambda o Azure) para enviar los datos directamente a Google Sheets o a tu base de datos.