Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Entusiasta de la investigación
¿Necesitas un pipeline robusto de imágenes médicas desde las salidas crudas del escáner hasta redes neuronales entrenadas?
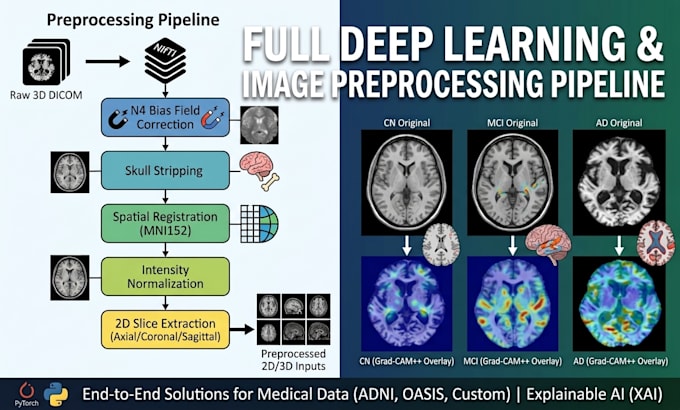
Las exploraciones en crudo (DICOM / NIfTI) no se pueden alimentar directamente en modelos de deep learning sin una alineación espacial adecuada y normalización de intensidad. Construyo pipelines completos de visión por computadora médica que manejan el preprocesamiento de datos, diseño de arquitecturas personalizadas y interpretabilidad del modelo.
1. Preprocesamiento de datos:
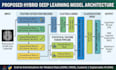
2. Deep learning y clasificación:
3. IA explicable (XAI):
Entregables:
¡Envíame un mensaje antes de ordenar para discutir tu conjunto de datos y requisitos!
Lenguaje de programación:
Python
•
MLflow
API:
Google Cloud Vision API
Herramientas:
Jupyter Notebook
•
opencv
•
TensorFlow
•
Excel
•
MLflow
Marcos:
Scikit-learn
•
Google ML Kit
•
keras
•
PyTorch
•
Panda
•
TensorFlow
Traducción automática
¿Qué formatos de imágenes médicas puedes manejar?
Puedo procesar formatos estándar de imágenes médicas en crudo, incluyendo DICOM (.dcm), NIfTI (.nii, .nii.gz), NRRD, así como formatos de imagen 2D (PNG, JPEG, TIFF). Ya sea que tu conjunto de datos consista en exploraciones volumétricas 3D o en conjuntos de cortes 2D extraídos, puedo construir un pipeline automatizado para gestionarlo.
¿Incluye tu pipeline preprocesamiento como eliminación de cráneo o corrección de sesgo?
Sí. Las exploraciones médicas en crudo requieren estandarización antes de ser alimentadas en modelos de deep learning. Mi flujo de trabajo de preprocesamiento cubre conversión de DICOM a NIfTI, reorientación espacial (alineación RAS), corrección de campo de sesgo N4, eliminación de cráneo/extracción cerebral, registro MNI152 y normalización de intensidad.
¿Qué frameworks y librerías de deep learning utilizas?
Principalmente construyo pipelines modulares y reproducibles en Python usando PyTorch, OpenCV, SimpleITK, NiBabel, NumPy y scikit-learn. Si necesitas específicamente TensorFlow o Keras, puedo adaptar la arquitectura del modelo a tu framework preferido bajo solicitud.
¿Cómo manejas el desequilibrio de clases en conjuntos de datos médicos?
Las clases desequilibradas (por ejemplo, menos muestras de enfermos que controles normales) pueden sesgar severamente los modelos de deep learning. Mitigo esto usando estrategias técnicas como muestreo aleatorio ponderado durante la creación del batch, funciones de pérdida de entropía cruzada ponderadas por clase y técnicas de aumento de datos para equilibrar.
¿Qué es Explainable AI (Grad-CAM++) y por qué lo necesito?
Las redes neuronales profundas a menudo son criticadas por ser "cajas negras". Grad-CAM++ genera mapas de calor de activación de clase directamente sobre tus exploraciones MRI/CT para resaltar visualmente las regiones cerebrales o anatómicas (como atrofia tisular o ventrículos agrandados) que impulsan la predicción del modelo. Esta interpretación ayuda a entender mejor el proceso.
¿Proporcionas diagnóstico médico o evaluación clínica de pacientes?
No. En total cumplimiento con las directrices de Fiverr, no ofrezco servicios de diagnóstico clínico, consulta con pacientes ni asesoramiento médico. Mis servicios se limitan estrictamente a ingeniería de software, preprocesamiento de datos, arquitectura de modelos de machine learning y asistencia técnica académica/de I+D.
¿Qué entregables recibiré cuando se complete el pedido?
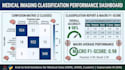
Dependiendo del paquete que elijas, recibirás código fuente modular, limpio en Python (o Jupyter Notebooks), archivos de pesos del modelo entrenado (.pt o .h5), scripts de preprocesamiento de datos, salidas de evaluación visual (matriz de confusión, curvas de pérdida/precisión, curvas ROC) y mapas de calor Grad-CAM++.
¿Podemos firmar un acuerdo de confidencialidad (NDA) o asegurar que mi conjunto de datos de investigación propietario permanezca privado?
Por supuesto. Tomo muy en serio la privacidad de los datos. Tu conjunto de datos y el código del proyecto permanecerán 100% confidenciales y nunca serán compartidos, publicados o reutilizados en ninguna forma. Estoy completamente abierto a firmar un Acuerdo de No Divulgación (NDA) antes de que envíes los archivos.