Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
¡Impulsa tu posicionamiento con contenido SEO de alta calidad!
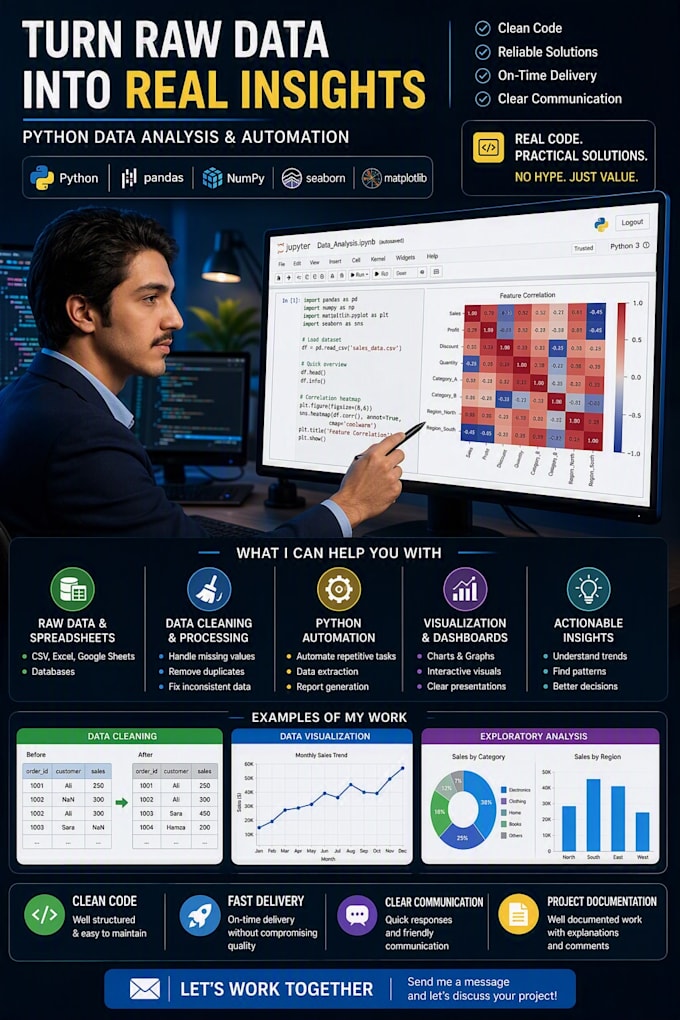
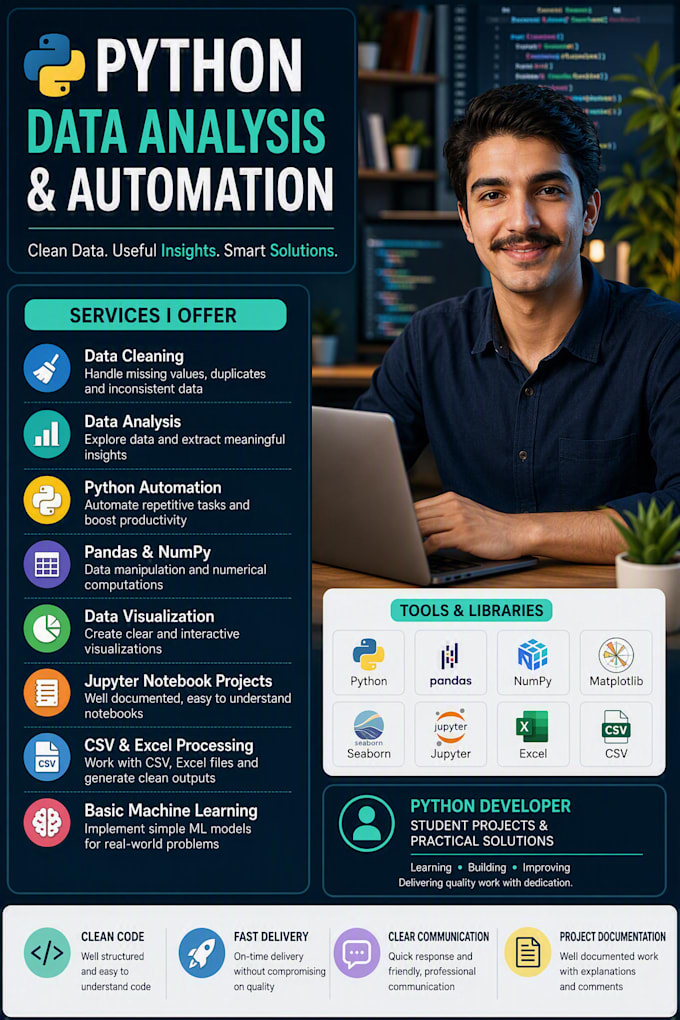
¿Buscas un desarrollador experto en Python para extraer insights de tu conjunto de datos o construir modelos predictivos de Machine Learning? Como graduado en Ciencias de la Computación certificado en IA y Data Science, transformo datos en bruto en soluciones comerciales limpias y accionables.
Servicios ofrecidos:
Herramientas y tecnologías:
¿Por qué trabajar conmigo?
Por favor, contáctame antes de hacer un pedido para revisar tu conjunto de datos y discutir.


Lenguaje de programación:
Python
•
SQL
Marcos:
Scikit-learn
•
Panda
•
Otros
Herramientas:
Jupyter Notebook
•
Excel
•
Colab
•
Otros
Traducción automática
¿Con qué formatos de datos trabajas?
Acepto CSV, Excel (.xlsx, .xls), JSON, archivos de bases de datos SQL, TSV y TXT. Si tus datos están en otro formato, ¡no dudes en enviarme un mensaje primero!
¿Recibiré el código fuente completo?
Sí, recibirás el código fuente completamente documentado y comentado en un Jupyter Notebook (.ipynb) o en un script limpio de Python (.py), según prefieras.
¿Qué pasa si mi conjunto de datos está desordenado o tiene valores faltantes?
El preprocesamiento y limpieza de datos (manejo de valores faltantes, valores atípicos, eliminación de duplicados y codificación) están incluidos en todos los paquetes antes de realizar cualquier análisis o modelado de machine learning.
¿Puedes explicarme los insights finales y el rendimiento del modelo?
¡Por supuesto! Proporciono gráficos de visualización claros y un informe resumen que explica las tendencias clave, la precisión del modelo, métricas de confusión y conclusiones prácticas.
¿Cómo empezamos nuestro proyecto?
Simplemente haz clic en el botón "Contáctame", adjunta tu conjunto de datos (o una muestra) y describe brevemente qué problema quieres resolver o qué insights necesitas.