Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
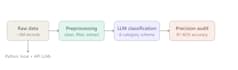
¿Necesitas convertir datos de texto no estructurado en categorías limpias y etiquetadas? Diseño y construyo pipelines de clasificación usando modelos de lenguaje grande (locales o basados en API) y Python, probados a escala en un proyecto que procesa aproximadamente 3 millones de registros de texto.
Lo que ofrezco:
- Esquemas de clasificación de texto personalizados adaptados a tus categorías
- Etiquetado basado en LLM (modelos locales como Llama, o APIs como DeepInfra/OpenAI)
- Pipelines de limpieza y preprocesamiento de datos en Python
- Auditoría de precisión para que sepas qué tan confiables son los resultados
- Documentación clara de la metodología y los resultados
Por qué trabajar conmigo:
Investigador con maestría (Universidad Médica de Taipei, GPA 4.0) con experiencia práctica en construir y validar sistemas de clasificación a gran escala. Me preocupo por la precisión, no solo por la velocidad. Cada pipeline que construyo incluye un paso de validación para que puedas confiar en los resultados.
Envíame tus datos y categorías, y definiré el enfoque adecuado para tu proyecto.