Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Traducción automática
Haz que el trabajo rutinario de documentos y carpetas sea más fácil de repetir.
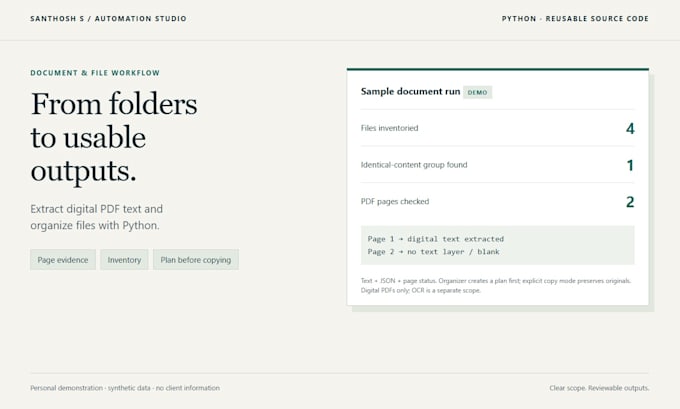
Construiré un flujo de trabajo local en Python para extraer el texto existente de PDFs digitales, inventariar un directorio, identificar contenido idéntico o crear una copia de carpeta organizada según reglas acordadas.
Las salidas pueden incluir un TXT por documento, JSON a nivel de página, un CSV de estado y un inventario con rutas relativas, tamaños y huellas SHA-256. Se marcan las páginas en blanco o aquellas sin contenido extraíble.
El organizador crea primero un plan revisable. El modo de copia explícita conserva los originales y verifica los resultados. No mueve ni elimina tu material fuente.
Recibes código reutilizable, instrucciones de ejecución, muestras de salida y un resumen. Mi demo personal usa datos sintéticos: cuatro ítems inventariados y una muestra de dos páginas verificada, incluyendo una página en blanco.
Escaneo, OCR, escritura a mano, reconstrucción de tablas, documentos bloqueados y web scraping requieren un alcance separado. El orden de lectura depende de la estructura original.
La versión Premium incluye un recorrido de configuración en Windows y 14 días de correcciones por defectos dentro del alcance entregado.
Envía una muestra saneada, conteos, tamaño total y el formato de salida que necesitas antes de elegir un paquete.
Senior Executive
Idiomas
Traducción automática
Traducción automática
¿Puedes procesar PDFs escaneados o imágenes?
Este paquete cubre PDFs digitales con una capa de texto existente. Las exploraciones y la escritura a mano requieren un flujo OCR separado. Las páginas sin texto se marcan en lugar de adivinar.
¿Se conservará la tabla y el diseño original del PDF?
No. La salida es texto extraído con evidencia de página. El orden de lectura del PDF varía, y la reconstrucción de tablas o la conservación del diseño requieren un alcance basado en muestras separado.
¿Moverá o eliminará tus archivos el organizador?
No. La ejecución por defecto genera un plan. Una ejecución de copias explícitas crea copias organizadas y verifica los hashes de contenido; los originales se conservan. El contenido duplicado se reporta solo.
¿Puedo volver a ejecutar la automatización?
Sí. Se incluye la fuente de Python y una guía de ejecución. Las entradas deben conservar la estructura acordada y cada ejecución escribe en una carpeta de salida nueva o vacía.
¿Qué reglas de organización están incluidas?
La versión Premium cubre agrupar por extensión o mes UTC modificado manteniendo la estructura de carpetas original. La clasificación por negocio o la extracción de campos de PDF se scopean por separado.
¿Qué archivos debes compartir?
Envía primero una muestra representativa saneada y conteos. Proporciona copias de PDF sin contraseña. No compartas contraseñas ni datos personales innecesarios. Confirmamos el alcance antes de procesar el lote completo.
¿Cuáles son los límites de archivos, páginas y tamaño?
Básico: 20 PDFs/100 páginas/50 MB. Estándar: 100 PDFs/500 páginas/200 MB más 1,000 archivos de inventario. Premium: 200 PDFs/1,000 páginas/300 MB más 5,000 archivos de inventario y hasta 2 GB de copias. Se aplican tanto el conteo de PDFs como los límites de páginas combinadas.
