Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de IA, experto en Chatbot LLM y Python Django
Web Scraping en Python | Extracción de datos | Automatización web
¿Necesitas una extracción de datos confiable sin campos faltantes, scripts rotos o bloqueos por IP? Creo scrapers en Python de alto rendimiento y flujos de trabajo de automatización que extraen datos estructurados incluso de sitios web complejos estáticos y dinámicos, manejando medidas anti-bot, proxies y límites de velocidad en el proceso.
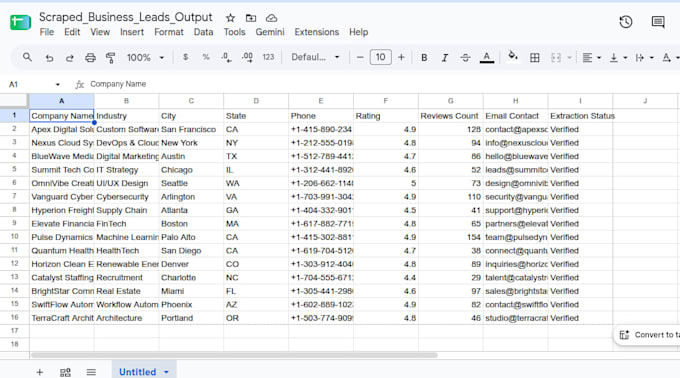
Lo que puedo raspar y extraer:
Entregables:
Pila tecnológica: Python, Selenium, Scrapy, BeautifulSoup, Playwright, Pandas
Envíame un mensaje con la URL del sitio web objetivo y los campos de datos que necesitas. Confirmaré la viabilidad y te daré un presupuesto preciso en unas horas.
Nota: La viabilidad depende de la estructura del sitio y las medidas anti-scraping implementadas.

Tecnología:
Python
•
scrapy
•
Selenium
•
Beautiful Soup
•
Pandas
Técnica:
Automatizado
Traducción automática
¿Funcionará esto en cualquier sitio web?
La mayoría de los sitios web, sí — incluyendo sitios con mucho JavaScript y dinámicos. Algunos sitios con protección anti-bot fuerte (CAPTCHAs estrictos, muros de inicio de sesión) pueden requerir más tiempo o no ser siempre posibles. Envíame primero la URL y te confirmaré.
¿Cómo manejas los bloqueos por IP o bloqueos?
Utilizo proxies, limitación de solicitudes y rotación de encabezados/agentes de usuario para evitar detecciones y mantener la extracción estable, especialmente para trabajos grandes o repetidos.
¿Puedes hacer scraping de datos detrás de un login?
Sí, si proporcionas credenciales válidas o acceso, puedo automatizar los flujos de inicio de sesión y raspar datos detrás de ellos.
¿En qué formato recibiré los datos?
Excel (.xlsx), CSV, JSON o sincronizado directamente con Google Sheets — lo que mejor te funcione.
¿Obtengo el código fuente del scraper?
Sí, disponible como complemento. Proporciono código en Python limpio y comentado para que puedas ejecutarlo o modificarlo tú mismo después.
¿Cómo manejas el scraping a gran escala (más de 10,000 registros)?
Utilizo solicitudes asíncronas, agrupamiento y rotación de proxies para raspar a gran escala sin fallar ni ser bloqueado, con manejo de errores y reintentos integrados.
¿Es legal el web scraping?
Solo raspo datos disponibles públicamente y sigo los términos de servicio de cada sitio cuando corresponda. No evado muros de pago ni extraigo datos privados o personales sin consentimiento.