Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
¿Buscas un ingeniero de datos con experiencia en Databricks para construir una tubería de datos fiable y escalable? Soy un Ingeniero de Datos certificado en Databricks con más de 5 años de experiencia creando pipelines ETL a gran escala usando PySpark, Spark SQL y Delta Lake para clientes globales en finanzas y salud.
Lo que entrego:
Por qué trabajar conmigo:
Si tienes más de 3 fuentes o requisitos personalizados, te enviaré una oferta a medida.
Traducción automática
¿Qué plataforma en la nube soportas?
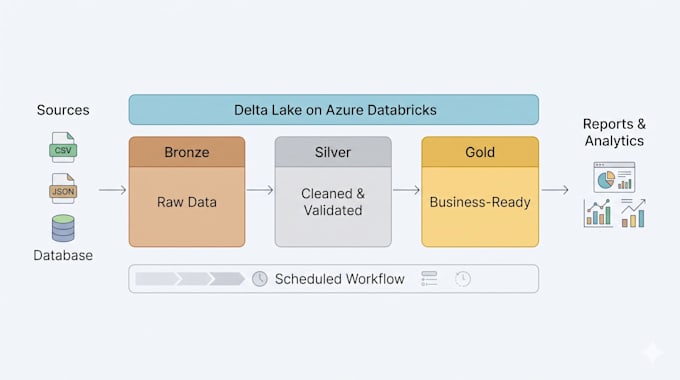
Me especializo en Azure Databricks, incluyendo almacenamiento ADLS Gen2 y Azure Data Factory.
¿Qué pasa si tengo más de 3 fuentes de datos?
Envíame un mensaje antes de hacer el pedido con tus requisitos y te enviaré una oferta personalizada.
¿Qué recibiré al final?
Cuadernos de PySpark/Spark SQL, un Databricks Workflow programado, un diagrama de arquitectura y documentación que explique cómo ejecutar y mantener la pipeline.
¿Puedes trabajar con el formato de datos que ya tengo?
Sí. Puedo ingerir CSV, JSON, Parquet, Delta y tablas de bases de datos. Comparte una muestra antes de pedir si tu formato es inusual.