Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de datos senior especializado en Cloud ETL y arquitectura
¿Aún dependes de actualizaciones lentas de SQL Server?
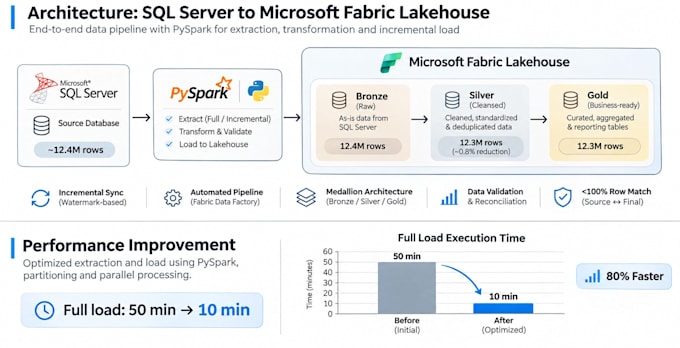
Migraré tus tablas de SQL Server a Microsoft Fabric Delta Lake, construyendo pipelines optimizados de carga completa y incremental basados en marcas de tiempo.
Lo que entrego:
Mi experiencia práctica: Construí pipelines de Fabric con actualizaciones por etapas y carga incremental, reduciendo el tiempo de ejecución de ~50 a ~10 minutos gracias a la optimización.
Ideal para equipos que modernizan flujos de trabajo legacy de SQL Server y SSIS.
Comparte tu esquema y conteos de filas para empezar. Envíame un mensaje antes de ordenar para migraciones grandes.
Tipo de proyecto:
Migración
Traducción automática
¿Trabajas con SQL Server on-premise o Azure SQL?
Ambos. Para on-premise, comparte un export del esquema y muestras de filas. Para Azure SQL, puedo conectar directamente. Menciona tu versión (SQL Server 2016, 2019, 2022 o Azure SQL) al escribir.
¿Necesito un espacio de Microsoft Fabric ya creado?
No. El paquete Premium incluye Lakehouse y configuración del workspace desde cero. Para Basic y Standard, se necesita una prueba de Fabric o un workspace de pago. Puedo guiarte en la configuración como complemento.
¿Qué es un pipeline incremental basado en marcas de tiempo?
Después de la carga inicial completa, el pipeline usa una columna de marca de tiempo o auto-incremento para extraer solo filas nuevas o cambiadas de SQL Server y hacer upsert en tablas Fabric Delta; no hace falta recargar todo. Tus datos se mantienen actualizados.
¿Puedes migrar procedimientos almacenados y vistas?
Se incluye la data de tablas y la lógica del pipeline PySpark. La conversión de procedimientos almacenados a cuadernos de Fabric o equivalentes en T-SQL puede añadirse como orden personalizada; mándame los detalles primero.
¿Cómo manejas tablas con 100 millones de filas o más?
Diseño con particionamiento, extracción por lotes y lógica incremental desde el inicio. Para tablas muy grandes, el plan de migración del paquete Basic incluirá la clave de partición recomendada y la estrategia de lotes antes de escribir cualquier código.
¿Obtengo el código y puedo mantenerlo yo mismo?
Sí. Todos los cuadernos PySpark, la lógica del pipeline y la documentación son tuyos. Las versiones Standard y Premium incluyen comentarios en el código y un README paso a paso para que tu equipo pueda ampliar o mantener los pipelines de forma independiente.