Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de datos senior especializado en Cloud ETL y arquitectura
¿Necesitas ayuda para procesar grandes conjuntos de datos con PySpark o Databricks?
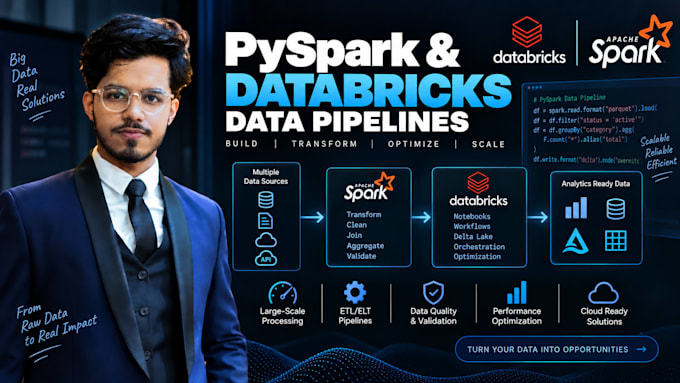
Construiré pipelines de datos escalables usando PySpark, Apache Spark y Databricks para transformación, procesamiento y análisis de datos.
Puedo ayudarte con:
Me enfoco en pipelines limpios, fáciles de mantener y eficientes, con documentación clara.
Contáctame antes de hacer un pedido para proyectos complejos, así puedo entender tus datos y requisitos.
Plataforma de almacenes:
Snowflake
•
Azure Synapse
•
Databricks
Tipo de proyecto:
Nueva creación
Traducción automática
¿Trabajas con Databricks?
Sí. Puedo crear notebooks, transformaciones, flujos de trabajo ETL y pipelines de procesamiento de datos en Databricks.
¿Puedes procesar grandes conjuntos de datos?
Sí. PySpark está diseñado para procesamiento distribuido, y puedo construir pipelines para grandes conjuntos de datos.
¿Puedes optimizar un pipeline Spark existente?
Sí. Puedo investigar trabajos lentos y optimizar transformaciones, uniones, particiones y cargas de trabajo en Spark.
¿Puedes construir pipelines incrementales?
Sí. Puedo implementar procesamiento incremental o por lotes según tus requisitos y datos disponibles.
¿Qué fuentes de datos puedes usar?
Puedo trabajar con archivos, APIs, bases de datos, almacenamiento en la nube y data warehouses, dependiendo del proyecto.
¿Puedes trabajar con Snowflake u otros warehouses?
Sí. Puedo construir pipelines que transformen datos y los carguen en plataformas como Snowflake y otros warehouses compatibles.
¿Proporcionas documentación?
Sí. La documentación está incluida según el paquete seleccionado.
¿Debo comunicarme con usted antes de realizar el pedido?
Sí, especialmente para proyectos complejos. Comparte tus fuentes de datos, transformaciones esperadas, destino y volumen aproximado de datos.
