Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de datos senior especializado en Cloud ETL y arquitectura
¿Necesitas una pipeline de ETL confiable para automatizar tu flujo de datos?
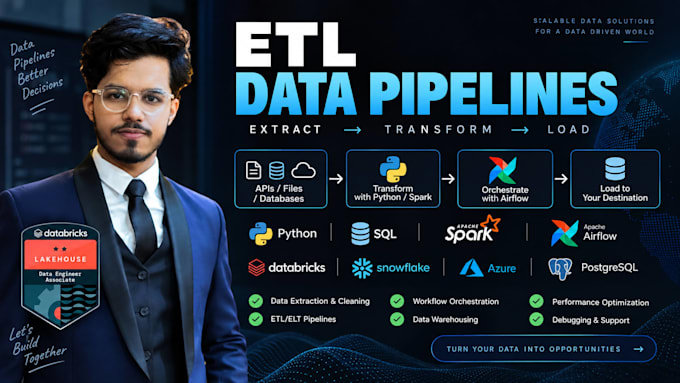
Construiré una pipeline de ETL/ELT limpia y escalable usando Python, SQL, Apache Spark/PySpark y Airflow.
Puedo ayudarte con:
Recibirás código limpio, fácil de mantener, documentación adecuada y una solución adaptada a tus necesidades.
¿Tienes una pipeline que no funciona? También puedo solucionar y optimizarla.
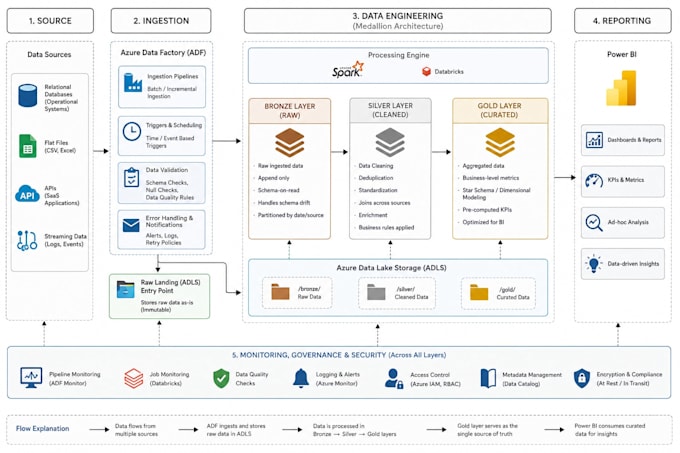
Herramientas y plataformas:
Azure Data Factory
Traducción automática
¿Con qué tipos de fuentes de datos puedes trabajar?
Puedo trabajar con bases de datos SQL, archivos CSV/Excel, APIs REST, almacenamiento en la nube, datos JSON y muchas otras fuentes de datos estructurados.
¿Puedes construir flujos de trabajo en Apache Airflow?
Sí. Puedo crear DAGs en Airflow con programación, dependencias, reintentos, registro y monitoreo.
¿Soportas Apache Spark?
Sí. Construyo pipelines en Spark para procesamiento de datos a gran escala, transformaciones y cargas ETL.
¿Puedes automatizar trabajos recurrentes de datos?
Por supuesto. Puedo crear pipelines programados que extraen, transforman, validan y cargan datos automáticamente.
¿Puedes desplegar el pipeline?
Sí. La asistencia en despliegue usando Docker o plataformas en la nube puede incluirse como un Gig Extra o en el paquete Premium.