Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
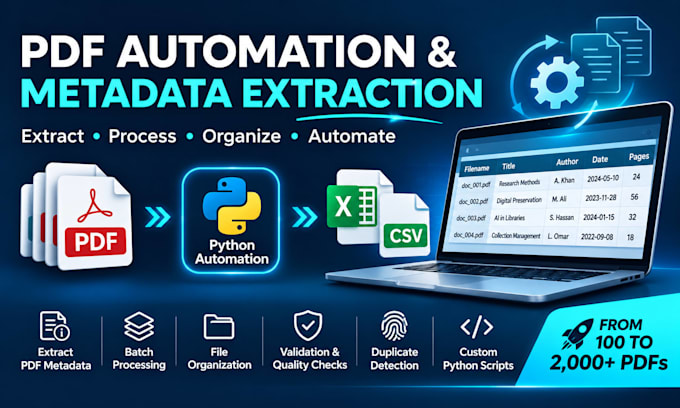
¿Necesitas procesar cientos o miles de archivos PDF de forma eficiente?
Desarrollo soluciones de automatización en Python para ayudar a empresas, investigadores y personas a extraer metadatos, organizar documentos y automatizar tareas repetitivas de procesamiento de PDFs.
Mis servicios incluyen:
¿Por qué elegir mi servicio?
Tengo experiencia práctica desarrollando flujos de trabajo de procesamiento de documentos y metadatos a gran escala. Me enfoco en soluciones confiables probadas con documentación clara.
Lo que recibirás:
Dependiendo de tu paquete, recibirás informes de metadatos estructurados, scripts de Python reutilizables o un flujo de procesamiento de PDF personalizado.
Por favor, contáctame antes de hacer tu pedido para discutir tus requisitos.
Nota: OCR, extracción de texto de documentos escaneados y diseños complejos requieren una cotización personalizada.
Tecnología:
Python
Experiencia:
Extracción de Datos
•
Manipulación de Datos
Traducción automática
¿Puedes procesar cientos o miles de archivos PDF?
¡Sí! Puedo desarrollar flujos de automatización en Python para procesar grandes colecciones de PDFs. Mis paquetes cubren hasta 100, 500 o 2000 archivos, dependiendo del paquete elegido. Colecciones más grandes pueden requerir una cotización personalizada.
¿Qué información puedes extraer de los archivos PDF?
Puedo extraer metadatos disponibles como títulos de documentos, autores, fechas de creación, fechas de modificación, conteos de páginas, tamaños de archivo y versiones de PDF. La extracción depende de la información integrada en cada documento.
¿Puedes extraer texto de PDFs escaneados?
Sí, la extracción basada en OCR se puede discutir como un servicio personalizado. Los paquetes estándar se enfocan en metadatos embebidos en PDF y no incluyen OCR ni reconocimiento de texto manuscrito.
¿En qué formatos recibiré los datos extraídos?
CSV está incluido en todos los paquetes. También se puede contar con salida en Excel (.xlsx) o JSON cuando se acuerde antes de la compra. Los scripts reutilizables en Python están incluidos en los paquetes Estándar y Premium.
¿Necesitas acceso a mi computadora o servidor?
Normalmente no se requiere acceso remoto. Puedo desarrollar y probar la solución usando archivos de muestra representativos. Luego podrás ejecutar el script entregado en tu equipo con Windows o Linux.
¿Cómo se manejan los documentos confidenciales?
Recomiendo compartir archivos de muestra anonimizados o no sensibles cuando sea posible. Solo utilizaré los archivos del proyecto para el trabajo acordado y no los compartiré con terceros. Por favor, comenta cualquier requisito especial de confidencialidad o manejo de datos antes de pedir el servicio.
¿Puedes crear un flujo de procesamiento de PDF personalizado?
¡Sí! Puedo desarrollar flujos de trabajo para extracción de metadatos, renombrado por lotes, detección de duplicados, validación de archivos y reportes estructurados. Contáctame con tus requisitos para que pueda evaluar el alcance y darte una cotización adecuada.
