Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
Descripción:
Enviar una función de LLM sin un conjunto de evaluación es ir a ciegas. Diseño y monto tuberías de evaluación que te dicen, con números, si tus prompts, modelo o configuração RAG realmente mejoraron antes que lo hagan tus usuarios.
Lo que obtienes:
Por favor, contáctame antes de realizar el pedido de error.
LLM AI Model Evaluation Specialist , QA automation Architect ,Eval pipelines
Idiomas
Traducción automática
Traducción automática
¿Necesito compartir mis datos de producción?
No. Trabajo con muestras que elijas, datos sintéticos o una exportación redactada. Todo queda bajo tu NDA y se elimina al entregar.
¿Qué herramientas de evaluación usas?
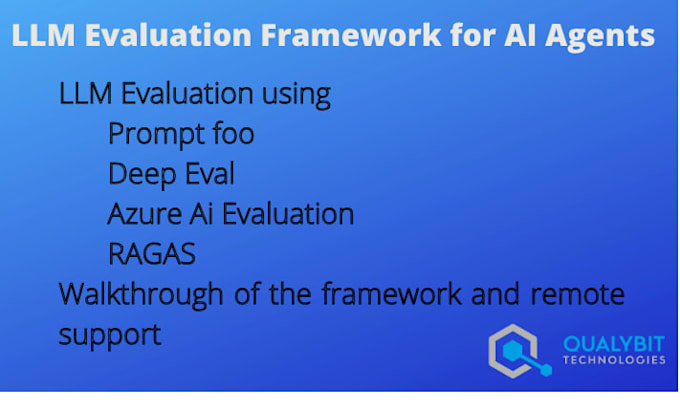
¿Qué herramientas de evaluación usas? Promptfoo, LangSmith, Ragas, DeepEval o un arnés de Python/pytest sencillo. Elijo lo que encaje con tu stack; el código es tuyo de cualquier modo.
¿Puedes evaluar un sistema RAG o un agente, no solo un solo prompt?
Sí. En RAG, evalúo recuperación y generación por separado (precisión de contexto/recall, fidelidad, relevancia de la respuesta). Para agentes, evalúo la corrección de llamadas a herramientas y la finalización de tareas.
¿Qué significa "LLM-as-judge" y es fiable?
Un segundo modelo califica las salidas según una rúbrica que elaboro contigo. La calibro con una muestra etiquetada por humanos para que sepas cuánto confiar en las puntuaciones.
¿También haces red-team o comparación de modelos?
Sí — ambos son servicios separados en mi perfil, o agréguelos como extras aquí.