Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Escalables SaaS y apps web, Ingeniero senior MERN, Rails y DevOps
¿tus integraciones de API están fallando, los trabajos de ETL están omitiendo registros o los paneles muestran datos incompletos?
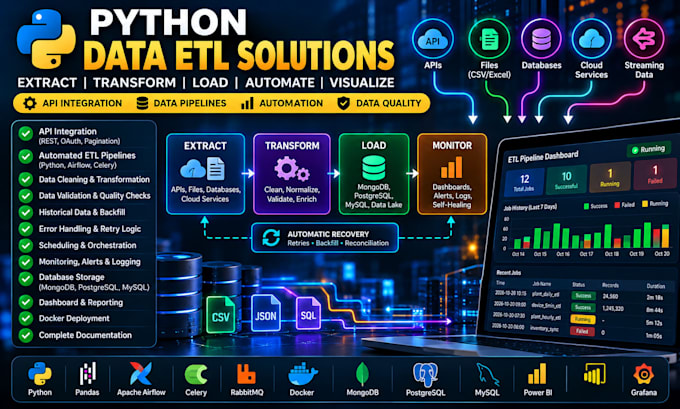
Construyo y reparo pipelines confiables de ETL/ELT en Python que mueven datos desde APIs REST, bases de datos, CSV/Excel y almacenamiento en la nube hacia conjuntos de datos limpios y utilizables.
Qué puedo entregar:
integración de API, paginación, manejo de OAuth y límites de consulta
ETL/ELT automatizados con Python, SQL, Pandas o Polars
Sincronización incremental, puntos de control, desduplicación y upserts seguros
Validación de datos, controles de calidad y conciliación de datos
Relleno de datos históricos, reintentos y recuperación de trabajos fallidos
Programación y colas de tareas usando cron, Celery/RabbitMQ o Airflow
Registros estructurados, alertas de fallos y tableros de monitoreo de pipelines
Integración PostgreSQL, MySQL, MongoDB, BigQuery o Snowflake
Despliegue con Docker, pruebas Pytest y documentación clara
Ideal para SaaS, comercio electrónico, IoT, finanzas y pipelines de reporting.
Me enfoco en flujos de trabajo recuperables y observables, no en scripts de una sola vez. El relleno depende del historial de la API fuente y de los límites de acceso.
Envíame un mensaje con tu fuente, destino y el problema actual antes de hacer el pedido.


Herramientas y plataformas:
Kafka Connect
•
Otros
Traducción automática
¿Puedes arreglar un pipeline ETL existente?
Sí. Puedo revisar scripts Python ETL existentes, investigar solicitudes de API fallidas, identificar errores de procesamiento de datos, mejorar operaciones de bases de datos e implementar mecanismos de reintento y recuperación adecuados.
¿Puede recuperar datos históricos faltantes?
Sí, siempre que la API fuente o la base de datos hagan disponibles los registros históricos. Puedo implementar flujos de relleno automático que identifiquen periodos ausentes, recuperen registros disponibles y actualicen tu base de datos de forma segura.
¿Proporcionas reintentos automáticos y recuperación de fallos?
Sí. Dependiendo de tus requisitos, puedo implementar lógica de reintento, backoff exponencial, seguimiento de trabajos persistente, colas de recuperación y ejecución de tareas con Celery y RabbitMQ.
¿Qué bases de datos soportan?
Puedo trabajar con bases de datos como PostgreSQL, MongoDB y MySQL. También se pueden discutir integraciones con almacenes en la nube, incluyendo BigQuery y Snowflake, según tus requisitos del proyecto.
¿Puedo monitorizar mis pipelines de datos?
Sí. Puedo implementar logs de ejecución, seguimiento del estado de trabajos, alertas de fallo, informes diarios de salud y interfaces de monitoreo personalizadas usando tecnologías backend basadas en Python.
¿Puedes garantizar que nunca se perderán datos?
Ningún sistema puede garantizar la disponibilidad de datos mantenidos por proveedores externos. Sin embargo, puedo implementar seguimiento de ejecución confiable, validación, reintentos, conciliación y mecanismos de recuperación para reducir pérdidas de datos evitables y detectar huecos no resueltos.