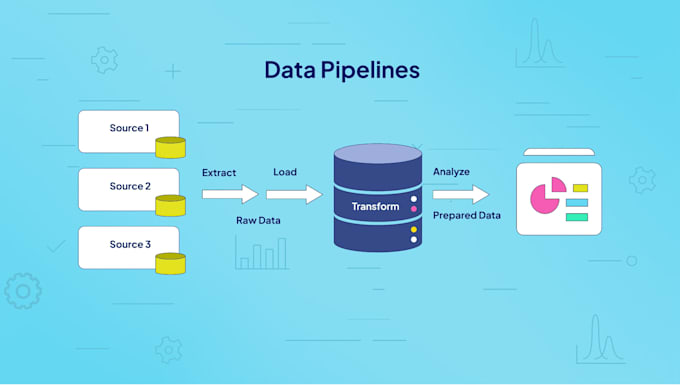
Soy un ingeniero de datos profesional con más de 3 años de experiencia diseñando y optimizando plataformas de datos a gran escala que procesan más de 400 TB diarios. Ya sea que necesites pipelines ETL de extremo a extremo, streaming en tiempo real o bases de datos analíticas rápidas, construyo sistemas de datos confiables y rentables.
Lo que puedo hacer por ti:
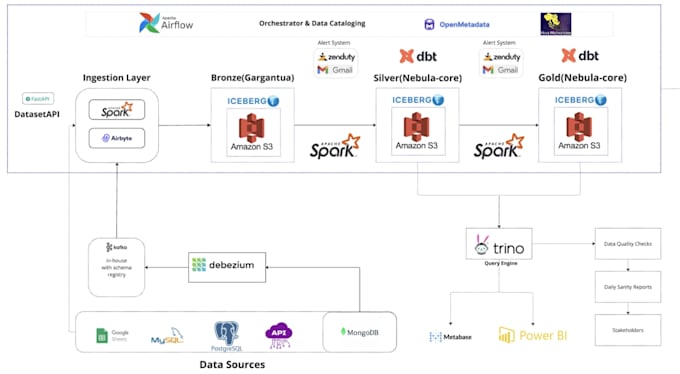
- Pipelines ETL y ELT: Diseñar y automatizar pipelines por lotes escalables usando Python, SQL, Apache Spark (PySpark) y Airflow.
- Lakehouse y Data Warehouse modernos: Arquitectura y configuración con Apache Iceberg, Trino, ClickHouse, Redshift y PostgreSQL.
- Transformaciones y modelado: Capas de oro y plata robustas con dbt, modelado de datos modular y pruebas.
- CDC en tiempo real y streaming: Integración con Kafka, Debezium CDC y ingestión en vivo en ClickHouse.
- Optimización de rendimiento: Mejorar consultas SQL complejas, resolver cuellos de botella y reducir costos de infraestructura.
¿Por qué trabajar conmigo?
- Estándares de ingeniería probados en producción
- Código escalable, limpio y completamente documentado
- Comunicación clara y entregas puntuales
Por favor, envíame un mensaje antes de hacer un pedido para discutir tu arquitectura y requisitos.