Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Utiliza todo el espacio de 1200 caracteres para hacer que la palabra clave del Gig sea rica en palabras clave pero aún legible:
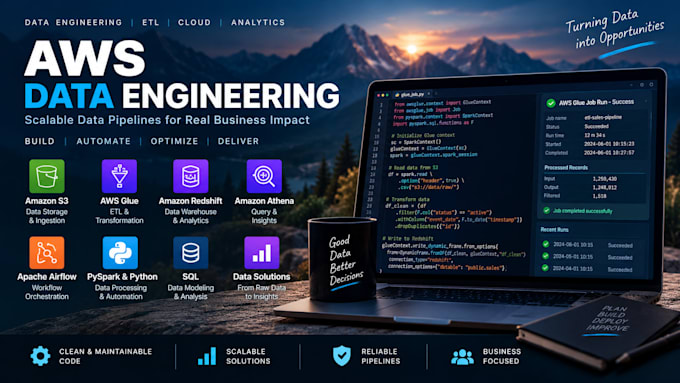
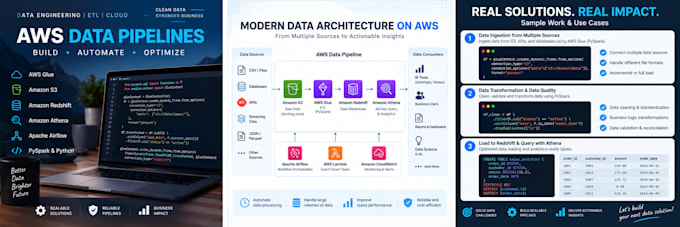
Construiré pipelines de datos ETL confiables y escalables en AWS usando AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift y otros servicios de AWS.
Puedo ayudarte a desarrollar nuevos pipelines de datos, automatizar el procesamiento de datos, transformar conjuntos de datos o solucionar problemas en flujos de trabajo ETL existentes.
Mis servicios incluyen:
Desarrollo de trabajos ETL con AWS Glue
Transformaciones de datos con PySpark y Python
Ingesta y procesamiento de datos en S3
Procesamiento de datos en CSV, JSON y Parquet
Carga y transformación de datos en Redshift
Soluciones Athena y Apache Iceberg
Validación y reconciliación de datos
Manejo de errores y registro de pipelines
Optimización del rendimiento de ETL
Migración y automatización de datos
Me enfoco en soluciones limpias, fáciles de mantener y listas para producción, con validación adecuada, manejo de errores y documentación.
Ya sea que necesites una tarea ETL pequeña o un pipeline completo de datos en AWS, puedo desarrollar una solución basada en tus requisitos.
Por favor, contacta conmigo antes de hacer un pedido para requisitos complejos o de múltiples servicios, así puedo entender tu alcance y recomendar el paquete adecuado.
Tecnología:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow