Explorar las categorías
Español
$
USD
Conéctate con tu IA
Ingeniero de datos y Python. Extracción de datos web, ETL, SQL, Generador de video con IA
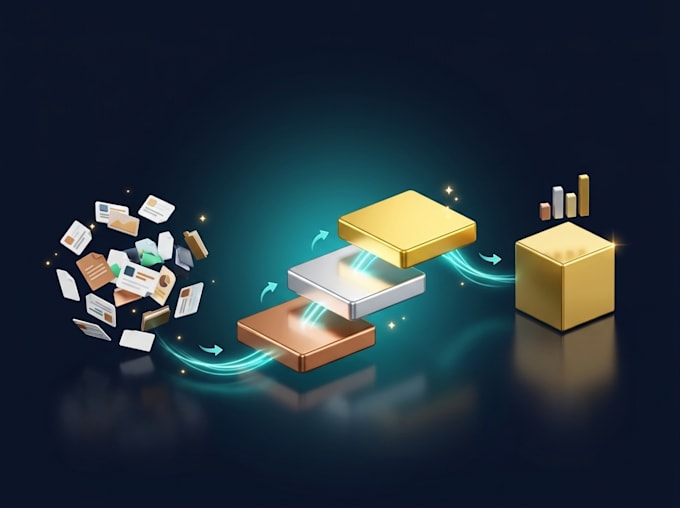
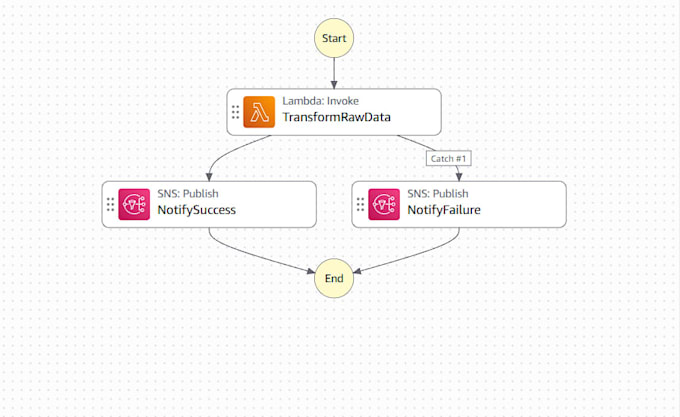
¿Tienes datos en bruto estancados en archivos CSV, APIs o tablas desordenadas? Los convertiré en tablas limpias y listas para analítica usando Databricks, PySpark y Delta Lake con la arquitectura Medallion (Bronze, Silver, Gold).
Qué obtendrás:
Capa Bronze: datos en bruto ingresados de forma segura, sin pérdidas
Capa Silver: datos limpios, deduplicados y estandarizados
Capa Gold: tablas listas para informes y dashboards
Cuadernos PySpark y SQL bien comentados
Cheques de calidad de datos (nulos, duplicados, formatos incorrectos)
Documentación simple para que tu equipo pueda mantenerlo
Mi prueba: implementé un proyecto end-to-end de Databricks que procesó más de 51,000 registros a través de las tres capas Medallion. Soy microphone1 Certified Data Engineer con formación en Cloud Data Engineer (Python, SQL, AWS, Snowflake, Spark).
Nota: la pipeline se ejecuta en tu espacio de trabajo de Databricks, así que posees tus datos. Una cuenta gratuita de Databricks es suficiente para proyectos pequeños.
Escríbeme antes de hacer el pedido con tu fuente de datos y objetivo, y te recomendaré el paquete adecuado.

Traducción automática
¿Necesito una cuenta Databricks de pago?
No. Una cuenta gratuita es suficiente para proyectos pequeños. Para cargas de trabajo más grandes puede hacer falta un espacio de trabajo pago a tu nombre.
¿Puedes mejorar mis cuadernos existentes?
Sí. Envíame los detalles y te haré una oferta personalizada.
¿Entenderé cómo funciona?
Sí. Los cuadernos están comentados y Premium incluye una revisión guiada.