Haré ingeniero de datos en azure databricks, pyspark, sql, etl, dbt

Parte de la información se ha traducido automáticamente.

India

Hablo Inglés

Azure Databricks, Ingeniero de datos, PySpark, Azure, SQL, ETL, Oracle

Ingeniero de datos con más de 3 años de experiencia en soporte de aplicaciones empresariales y bases de datos en TI, especializado en Oracle SQL/PLSQL, procesamiento de datos, ETL y operaciones de bas...
Acerca de este Servicio
  • Construyo y mantengo pipelines de datos ETL/ELT usando Databricks, PySpark, Python y SQL.
  • Trabajo con plataformas en la nube Azure y AWS, principalmente usando ADLS Gen2 y Amazon S3 para almacenamiento de datos.
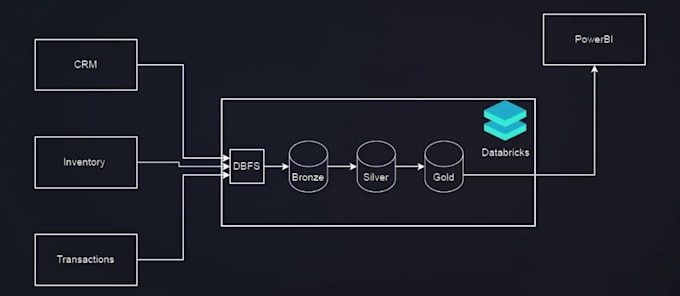
  • Desarrollo notebooks de Databricks para extraer, transformar, limpiar y cargar datos desde diferentes fuentes.
  • Utilizo PySpark para procesar grandes conjuntos de datos y realizar joins, agregaciones, filtrados y transformaciones.
  • Trabajo con Delta Lake para crear tablas de datos confiables y escalables.
  • Diseño capas Bronze, Silver y Gold para organizar y procesar datos de manera eficiente.
  • Conecto Databricks con bases de datos como Oracle, SQL Server, MySQL y PostgreSQL.
  • Creo consultas SQL para extraer, transformar, validar y analizar datos.
  • Construyo pipelines de datos por lotes e incrementales según los requerimientos del negocio.
  • Programo y automatizo pipelines usando Databricks Workflows y Jobs.
  • Utilizo Azure Data Factory para orquestar pipelines e integrar con servicios de Azure.
  • Realizo verificaciones de calidad de datos, incluyendo manejo de valores nulos, duplicados, datos incorrectos y cambios en el esquema.
  • Soluciono fallos en pipelines y investigo problemas de datos y trabajos en Spark.
  • Optimizo trabajos de PySpark usando técnicas como particionamiento y caching.

Plataforma de almacenes:

redshift

•

Fabric Warehouse

•

Databricks

Tipo de proyecto:

Nueva creación

Etiquetas relacionadas