Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
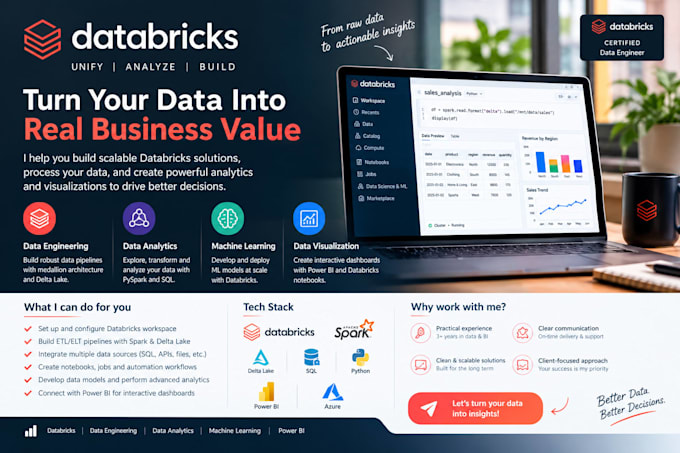
Transforma tus datos en bruto en pipelines de datos confiables con Databricks!
¿Buscas ayuda con procesamiento de datos, pipelines ETL o transformación de big data usando Databricks?
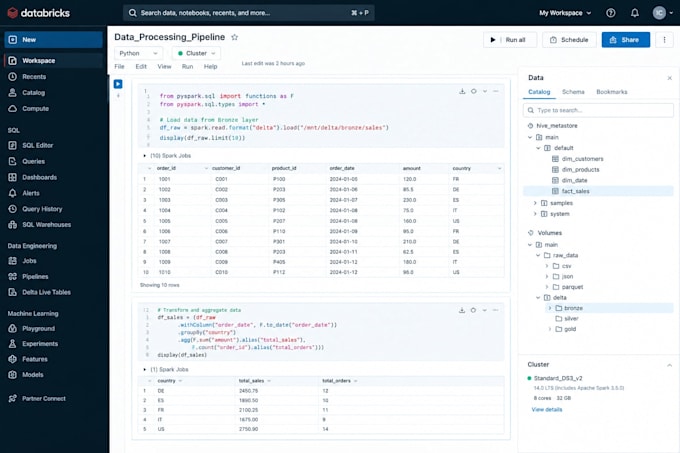
Puedo ayudarte a construir, optimizar y mantener pipelines de datos usando Databricks, PySpark, Python, SQL y Delta Lake, adaptados a los requisitos de tu proyecto.
Con más de 3 años de experiencia en análisis de datos, desarrollo ETL, transformación de datos y inteligencia empresarial, sé cómo convertir datos en bruto en conjuntos de datos estructurados, confiables y listos para análisis.
Mis servicios en Databricks
1. Desarrollo en Databricks y PySpark
2. Pipelines ETL/ELT de datos
3. Delta Lake y Lakehouse
4. SQL y optimización de datos
Traducción automática
¿Cuáles son tus fuentes y formatos de datos de entrada?
¿Ya tienes un espacio de trabajo en Databricks?
Qué necesitas para empezar?
Por favor, proporciona los requisitos de tu proyecto, datos de muestra, resultado esperado y detalles sobre tu entorno de Databricks.