Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de IA: agentes LLM, RAG, Document AI, visión por computadora y análisis de video
Nivel 1
Ha cumplido determinados criterios de rendimiento y muestra un gran potencial en la plataforma.
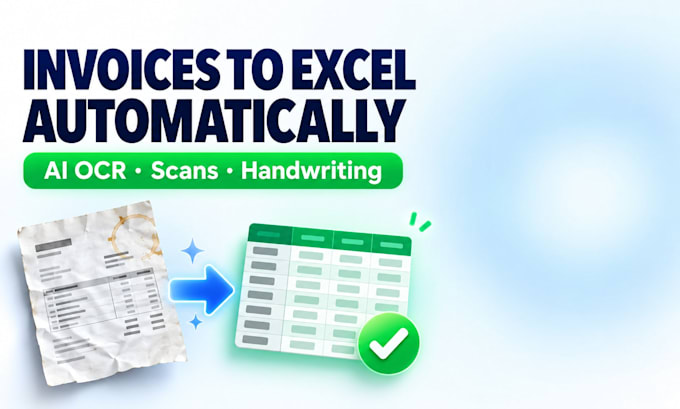
Aún pagas para que alguien te tipeé datos de facturas, recibos o formularios a mano?
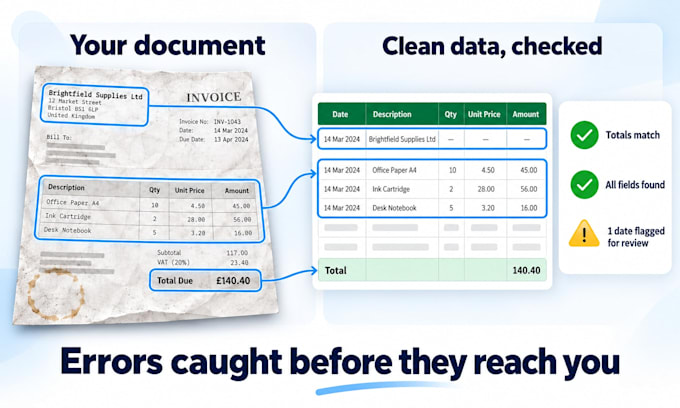
Construyo sistemas OCR de IA que leen tus documentos y devuelven datos limpios y estructurados directamente en Excel, Google Sheets, tu base de datos o tu app.
LO QUE EXTRAIGO
- Facturas y recibos: conceptos, totales, fechas, impuestos, datos del proveedor
- Extractos bancarios, órdenes de compra y albaranes
- Documentos de identidad y KYC: pasaportes, licencias, identificaciones nacionales
- Contratos y formularios: campos, firmas, casillas
- Páginas escritas a mano y escaneadas de baja calidad
- Tablas, incluso cuando se extienden a varias páginas
POR QUÉ ES DIFERENTE
Cada trabajo incluye reglas de validación que detectan errores antes de que lleguen a ti: totales que no coinciden, campos faltantes, fechas imposibles. También obtendrás un informe de precisión medido en TUS documentos, no en una demo.
STACK: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, vision LLMs.
¿NO ESTÁS SEGURO DE QUE FUNCIONE EN TUS DOCUMENTOS?
Envíame 2 o 3 muestras y los campos que necesitas antes de hacer el pedido. Te diré con sinceridad qué precisión esperar.

Tecnología:
Excel
•
Hojas de cálculo de Google
•
Python
•
Zapier
•
Otros
Traducción automática
¿Esto funcionará con mis documentos específicos?
Eso es exactamente para lo que sirve el paquete de Prueba de Concepto. Envía 3-5 de tus documentos reales y realizaré la extracción y te mostraré los resultados con un informe de precisión antes de que te comprometas con algo más grande. Si tus documentos no encajan bien, lo descubrirás por una pequeña cantidad.
¿Qué precisión puedo esperar?
Depende de tus documentos, y cualquiera que te dé un presupuesto sin verlos está adivinando. PDFs digitales limpios con diseños consistentes suelen tener una precisión muy alta. Escaneos de mala calidad, escritura a mano y diseños muy variables son más difíciles. Por eso, cada paquete incluye un informe de precisión que mide la exactitud.
¿Obtengo el código fuente y una API funcional?
Sí, desde el paquete Estándar en adelante. Obtienes el código fuente completo, y el paquete Premium incluye una API, despliegue en tu propio servidor, con Docker y documentación para que tu equipo pueda mantenerlo sin mí.
Mis documentos son confidenciales. ¿Mi información está segura?
Sí, y seré específico al respecto. Solo necesito documentos de muestra, y puedes ocultar valores sensibles antes de enviarlos. Si tus documentos no pueden ser procesados por un servicio externo en absoluto, puedo construir toda la pipeline con OCR de código abierto auto-hospedado para que nada salga de tu infraestructura. Te
¿Puedes manejar texto manuscrito o escaneos de baja calidad?
A menudo sí, pero honestamente varía más que el texto impreso. Escritura a mano, escaneos desvanecidos, fotos inclinadas y faxes de baja resolución reducen la precisión, y la magnitud depende de tus documentos específicos. El preprocesamiento ayuda mucho. Envía muestras de tus peores documentos en la Prueba de Concepto y yo
¿Qué formato de salida obtengo?
Lo que encaje en tu flujo de trabajo: JSON estructurado, CSV, Excel o directamente en tu base de datos o app vía API. Dime dónde necesitas que termine la data y te la entregaré en ese formato en lugar de darte un archivo para que lo conviertas tú mismo.
¿Solo necesito que conviertas mis PDFs una vez, no un sistema entero? ¿Puedes hacerlo?
Sí. El paquete Básico es exactamente eso: envía hasta 50 páginas de un tipo de documento y te devuelvo un archivo limpio en Excel, CSV o JSON. Si luego quieres automatizarlo, el paquete Estándar convierte la misma configuración en un flujo de trabajo reutilizable.