Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
¿Necesitas un sistema de IA personalizado, no solo un envoltorio alrededor de una API? Lo planifico, lo construyo desde cero y te entrego el código.
Muhammad Omaid, jefe de IA en Magnus Mage (fundada en 2019): más de 8 años en producción, más de 10 ingenieros, 4 sistemas de IA en funcionamiento.
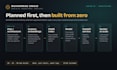
Los primeros 5 a 10 días son de planificación: arquitectura, selección de librerías, un plan escrito que apruebes antes del código.
Lo que construimos desde cero:
RAG: embeddings personalizados, codificación y decodificación ajustadas, FAISS o pgvector, recuperación agrupada en 3D para ajustar el fragmentado y la recuperación.
Post-entrenamiento: SFT, DPO, QLoRA en Llama, Qwen o Mistral, con informes de evaluación; inferencia privada en tus GPUs.
Multi-LLM: enrutamiento entre modelos abiertos y alojados según costo, latencia y sensibilidad de datos.
Servicios FastAPI con esquemas Pydantic, trabajadores asíncronos y contratos OpenAPI.
Contenedores Docker empresariales para tráfico alto: probados en carga, monitoreados, en AWS, Kubernetes o en local.
Seguridad: autenticación, límites de tasa, registro de auditoría.
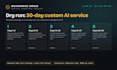
Paquetes: MVP en 30 días, Avanzado en 45; Enterprise es un equipo dedicado por 10,000 dólares al mes.
Obtienes código fuente, documento de arquitectura, informes de carga y evaluación, CI/CD, video de recorrido, ventana de corrección de errores.
Contáctanos antes de ordenar con tu caso de uso, datos y tráfico para una cotización personalizada.
Head of AI at Magnus Mage, LLM RAG and fine tuned models
Idiomas
Traducción automática
Traducción automática
¿Qué sucede en la fase de planificación?
Días 1-5 (MVP) o 1-10 (Avanzado): mapeamos tu caso de uso, datos y tráfico, elegimos la arquitectura y librerías (FastAPI, FAISS o pgvector, Transformers, Docker, Kubernetes) y redactamos un plan con hitos. Lo apruebas antes de escribir cualquier código.
¿Qué significa RAG construido desde cero?
Sin plantillas de frameworks. Entrenamos o ajustamos embeddings personalizados, ajustamos la codificación y decodificación para tus documentos, indexamos en FAISS o pgvector y agrupamos el espacio de recuperación en 3D para ajustar tamaño de fragmento y recuperación. Obtienes métricas de recuperación, no solo un chatbot.
¿Qué es post-entrenamiento y cuándo lo necesito?
El post-entrenamiento adapta un modelo abierto (Llama, Qwen, Mistral) a tus datos con SFT, DPO o QLoRA. Lo necesitas cuando los prompts y RAG no son suficientes: lenguaje del dominio, formatos de salida estrictos, llamadas a herramientas. Incluido en Avanzado y Enterprise, con informe de evaluación antes y después.
¿Qué es enrutamiento multi-LLM?
Una API, varios modelos. Las solicitudes se enrutaron por costo, latencia y sensibilidad de datos: datos sensibles permanecen en tu modelo privado, tareas generales van a un modelo alojado, con fallback y seguimiento de costos por llamada. Incluido en Avanzado y Enterprise.
¿Por qué FastAPI y Pydantic?
FastAPI ofrece servicios asíncronos y de alto rendimiento con contratos OpenAPI integrados; los esquemas Pydantic validan cada solicitud y respuesta para que la capa LLM nunca reciba ni devuelva datos mal formados. Ambos están escritos desde cero para tu sistema, sin generadores de boilerplate.
¿Cómo manejas el tráfico alto?
Contenedores Docker empresariales con trabajadores asíncronos y colas, escalado horizontal en Kubernetes o AWS, caché, límites de tasa y prueba de carga en tu tráfico objetivo antes de la entrega. Monitoreo y alertas incluidos en Avanzado y Enterprise.
¿Puede correr en mi infraestructura propia?
Sí. Todo se envía como contenedores Docker y funciona en tu nube (AWS, GCP, Azure), Kubernetes o en GPUs locales. Para inferencia privada servimos modelos abiertos con vLLM u Ollama, así que tus datos nunca salen de tu red.
¿MVP, Avanzado o Enterprise: cuál escoger?
MVP (30 días): un servicio de IA con RAG, FastAPI y Docker. Avanzado (45 días): MVP más un modelo post-entrenado, enrutamiento multi-LLM, agrupamiento en 3D y monitoreo. Enterprise: un equipo dedicado por 10,000 dólares al mes, mínimo dos meses, renovable según necesites.
¿Qué recibo al final?
Código fuente en tu repositorio, documento de arquitectura, informes de carga y evaluación, pipeline CI/CD, imágenes Docker, video de recorrido y ventana de corrección de errores. Eres dueño del código, los pesos del modelo y los datos.
¿Cómo trabajamos juntos?
Contáctanos antes de ordenar con tu caso de uso, datos y tráfico; te respondemos con un plan y una cotización personalizada. Durante la construcción: actualizaciones diarias en Fiverr, hitos, una demo al final de cada fase. NDA a solicitud.


