Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Level 1
Traducción automática
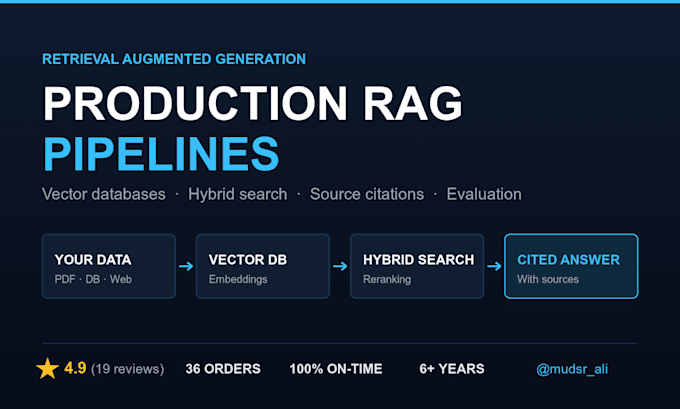
¿Necesitas un chatbot RAG o una pipeline de recuperación que haga más que simplemente enviar documentos a un LLM?
Construyo sistemas personalizados de Retrieval-Augmented Generation (RAG) que recuperan información relevante de tus datos y la usan para generar respuestas contextuales.
Lo que puedo construir:
Pila tecnológica: Python, FastAPI, LangChain o LlamaIndex cuando sea apropiado, PostgreSQL/pgvector, Qdrant, Chroma y otros almacenes de vectores compatibles.
Puedo ayudarte a construir una nueva pipeline RAG, mejorar una implementación existente o integrar recuperación en tu aplicación.
Cada proyecto tiene datos diferentes, requisitos de calidad y restricciones de infraestructura. Por favor, envíame un mensaje con tu caso de uso, fuentes de datos y resultado esperado antes de ordenar para que podamos acordar el alcance adecuado.
Senior Software Engineer, SaaS, Backend, Cloud, Ai
Level 1
Idiomas
Traducción automática
Traducción automática
¿Qué paquete se ajusta a mi proyecto?
Dime aproximadamente cuánta información tienes y dónde está. La opción starter es para una sola fuente de menos de 500 páginas. La opción production es para un corpus completo donde importa la precisión de las respuestas. La plataforma es para múltiples sistemas que cambian constantemente.
¿Qué base de datos vectorial usas?
Cualquiera que se ajuste a tu caso: Pinecone, Qdrant, Weaviate, Chroma o pgvector. Si ya usas PostgreSQL, pgvector suele evitar un nuevo servicio y costo por completo. Recomiendo según escala y presupuesto, no por preferencia.
¿Qué tan precisas serán las respuestas?
No prometo un número antes de ver tus datos. Lo que sí prometo es medición: la opción Standard y Premium incluyen un conjunto de evaluación para que veas la precisión de recuperación como una cifra, y cada respuesta lleva citas para que puedas rastrear cualquier error.
¿Quién paga por el uso de la API de OpenAI o Claude?
Tú tienes el control en tus propias cuentas, así mantienes la visibilidad total del gasto. Los costos de embedding y consulta son los principales factores. Estimo tu costo mensual realista antes de comenzar y añado caché y límites de tokens para reducirlo.
¿Mis datos se mantienen privados?
Todo funciona en tu propia infraestructura y cuentas de proveedor. Uso endpoints de API que no entrenan con tus datos, y firmaré un acuerdo de confidencialidad. Si tus documentos no pueden salir de tus servidores en absoluto, puedo construir una solución completamente autoalojada con modelos abiertos.
¿Qué necesitas de mí para empezar?
Una muestra de tus documentos o acceso a la base de datos, de 10 a 20 preguntas de ejemplo que los usuarios harán, y tu clave API del proveedor. Las preguntas de ejemplo son lo más importante: se convierten en el conjunto de evaluación contra el cual ajusto la recuperación.
