Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de automatización y IA
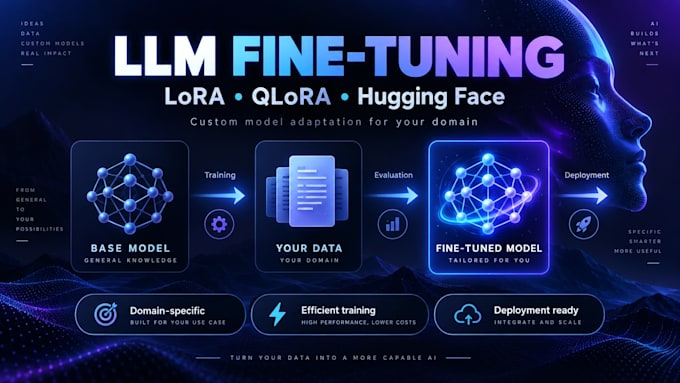
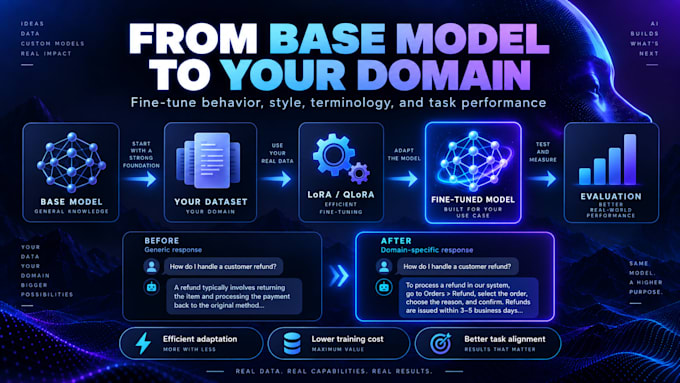
¿Necesitas un LLM que entienda mejor tu dominio, terminología, estilo de escritura, tarea o conjunto de datos propietario que el modelo base?
Voy a ajustar un modelo de lenguaje grande de código abierto usando técnicas modernas y eficientes en parámetros como LoRA y QLoRA, utilizando el ecosistema de Hugging Face.
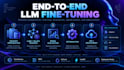
En lugar de simplemente ejecutar un script de entrenamiento, me concentro en todo el flujo de trabajo de ajuste fino:
Conjunto de datos -> Entrenamiento -> Evaluación -> Inferencia -> Implementación
Puedo ayudarte con:
Puedo trabajar con modelos de código abierto adecuados del ecosistema de Hugging Face, incluyendo la familia Llama, Qwen, Mistral, Gemma y modelos de lenguaje basados en transformer similares.

Fortinet
Cybersecurity
I worked with Sken.ai, now acquired by Fortinet, on a short-term project, conducting machine learning experiments on proprietary data. Using AWS, I focused on finding patterns, clustering, and classification within textual data.
abr 2021-abr 2021
Traducción automática
¿Qué es LoRA?
LoRA es una técnica de ajuste fino eficiente en parámetros que adapta un modelo de lenguaje grande entrenando un número relativamente pequeño de parámetros adicionales en lugar de actualizar todo el modelo. Esto reduce significativamente el uso de memoria en GPU y los requisitos de entrenamiento.
¿Qué es QLoRA?
QLoRA combina cuantización con LoRA para que los modelos grandes puedan ser ajustados usando mucho menos memoria de GPU, manteniendo gran parte de su capacidad original. Es especialmente útil cuando los recursos de computación son limitados.
¿Puedes ajustar finamente cualquier modelo de Hugging Face?
Puedo trabajar con muchos modelos basados en transformers que soportan ajuste fino práctico a través del ecosistema de Hugging Face. Por favor, envíame el modelo exacto o tus requisitos antes de hacer el pedido, ya que el hardware, la arquitectura, la licencia y el tamaño del dataset pueden afectar la viabilidad.
¿Puedes ajustar finamente modelos como Llama, Qwen, Mistral o Gemma?
Sí, siempre que el modelo seleccionado, el hardware, la licencia y los requisitos del proyecto lo permitan. Recomendaré el tamaño del modelo y la estrategia de ajuste fino según tu tarea y los recursos de computación disponibles.
¿Necesito un conjunto de datos?
Sí. El ajuste fino requiere datos de entrenamiento adecuados. Si tu dataset necesita una ligera reestructuración o formateo, eso puede incluirse dependiendo del paquete.
¿Cuánta data necesito?
Depende de la tarea y la calidad de los ejemplos. Un dataset pequeño y de alta calidad a veces puede superar a uno mucho más grande y ruidoso. Evaluaré el dataset antes del entrenamiento y recomendaré si es adecuado.
¿Puedes garantizar que el modelo ajustado será mejor?
Ningún ingeniero de IA responsable debería garantizar eso antes de probarlo. El rendimiento depende del modelo base, la calidad del dataset, el tamaño del dataset, la configuración de entrenamiento, el método de evaluación y la tarea objetivo. Por eso la evaluación está incluida en mi flujo de trabajo.
¿Debería usar RAG o ajuste fino?
Resuelven problemas diferentes. RAG suele ser apropiado cuando el modelo necesita acceso a conocimientos cambiantes o privados. El ajuste fino es útil cuando quieres cambiar el comportamiento del modelo, la adaptación a un dominio, estilo, terminología, formato de salida o rendimiento en tareas. Algunos sistemas se benefician de ambos.
¿Puedes desplegar el modelo ajustado?
Sí. El paquete Premium puede incluir una API de inferencia, configuración de Docker, documentación de despliegue y orientación para la integración. Los costos de infraestructura en la nube y hosting en GPU son aparte.
¿Quién paga por el entrenamiento en GPU/nube?
Cualquier costo significativo de terceros por GPU, API, almacenamiento o hosting lo paga el cliente, a menos que esté explícitamente incluido en la oferta personalizada. Discutiré los requisitos de computación esperados antes del entrenamiento.
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj

Estados Unidos
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
USD 100-USD 200
$
4 días
Tiempo
kr1s_ra

Austria
Pleasure doing business. Very fast delivery.
USD 50
$
3 días
Tiempo
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj
Estados Unidos
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
USD 100-USD 200
$
4 días
Tiempo
kr1s_ra
Austria
Pleasure doing business. Very fast delivery.
USD 50
$
3 días
Tiempo