Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Transformo datos en soluciones con precisión
¿Necesitas un ingeniero de datos para tus pipelines ETL? ¿Airflow DAG fallando? ¿un trabajo de Spark quedándose sin memoria? Arreglo pipelines de datos rotos rápido y luego me aseguro de que no vuelvan a fallar.
¿Cansado de fallos de DAG a las 2 de la madrugada? Añadiré un agente de IA a tu pila de Airflow + Spark que diagnostica fallos, corrige automáticamente los que son seguros y te envía un informe claro de la causa raíz para el resto.
Qué obtendrás:
La pila tecnológica: Airflow, Spark, Kafka, NiFi, HDFS, MinIO, Agentic Frameworks.

Traducción automática
¿En qué se diferencia el ETL agentico del ETL tradicional?
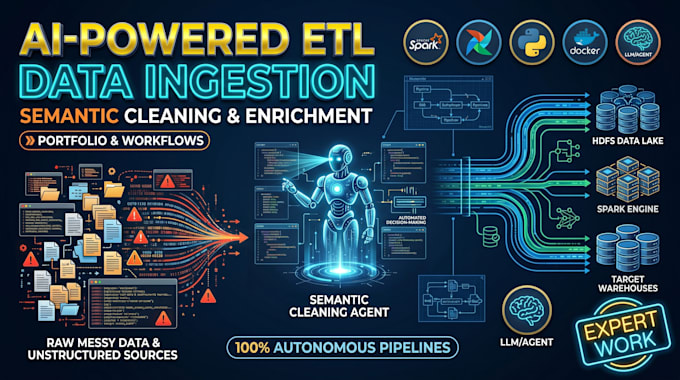
El ETL tradicional depende de reglas rígidas y codificadas que se rompen cuando cambian los formatos de datos. Mis pipelines ETL agenticos usan IA para entender semánticamente, analizar y limpiar datos no estructurados o desordenados antes de ingresarlos de forma segura en tu data lake HDFS, haciendo que el pipeline sea muy resistente.
¿Mi data empresarial está segura al usar estos agentes de IA?
Aunque podemos integrar APIs comerciales, me especializo en desplegar LLMs seguros y locales (como Qwen, DeepSeek, agentes basados en frameworks) directamente en tu entorno containerizado. Esto garantiza que tus datos sensibles nunca salgan de tu red interna o clúster.
¿Necesito migrar de mi infraestructura actual?
No. Diseño estos flujos de trabajo agenticos para integrarse perfectamente con tus configuraciones existentes de Apache Airflow y Spark. Empaqueto todo usando Docker (o Docker Swarm para alta disponibilidad) para que se conecte directamente a tu arquitectura actual.
¿Qué pasa si el agente no puede solucionar una falla?
Se escala. Recibes una alerta en Slack o por correo electrónico con la causa raíz, las líneas de registro relevantes y una solución sugerida. Los cambios riesgosos (código, esquema, cualquier cosa que toque datos de producción) siempre necesitan tu aprobación. El agente solo corrige automáticamente los tipos de fallas que hemos acordado que son seguros.
¿Puedes construir una nueva tubería ETL desde cero, no solo arreglar una?
Sí. Diseño y construyo pipelines de datos de extremo a extremo: ingestión desde APIs, bases de datos o archivos, transformación en PySpark o Python, orquestación en Apache Airflow y carga en PostgreSQL, S3, Hive o tu data warehouse.