Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
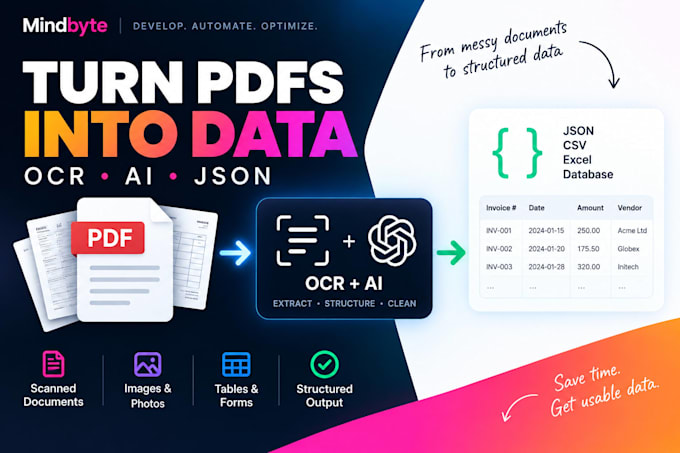
Construyo pipelines de OCR y procesamiento de documentos que convierten PDFs, escaneos e imágenes en datos estructurados y utilizables.
Puedo extraer texto, tablas, fechas, referencias, IDs y campos personalizados, clasificar documentos, limpiar los resultados y devolver salidas estructuradas en JSON, CSV o listas para bases de datos.
Dependiendo del proyecto, también puedo crear APIs, procesamiento asíncrono, búsqueda semántica o flujos de trabajo RAG.
Mi enfoque está en un procesamiento de documentos confiable y reutilizable en lugar de una simple conversión de PDF puntual.
Por favor, envía muestras representativas de documentos antes de solicitar proyectos complejos.
Tecnología:
Python
Traducción automática
¿Puedes procesar PDFs escaneados?
Sí. Puedo procesar PDFs escaneados e imágenes, incluyendo preprocesamiento cuando sea necesario.
¿Puedes extraer campos específicos?
Sí. Se pueden extraer fechas, IDs, referencias, títulos, tipos de documentos y otros campos.
¿Puedes clasificar documentos?
Sí. La clasificación puede usar reglas, aprendizaje automático o AI dependiendo del caso de uso.
¿Puedes extraer tablas?
Sí, dependiendo del diseño del documento y la calidad del escaneo.
¿Puedes construir una API alrededor de la canalización?
Sí. Se puede agregar una API REST y procesamiento en segundo plano.
¿Puedes procesar volúmenes grandes?
Sí, pero los flujos de trabajo de alto volumen generalmente requieren un alcance personalizado.
