Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
Deja de pagar tarifas mensuales a OpenAI y protege tus datos con IA local privada al 100%
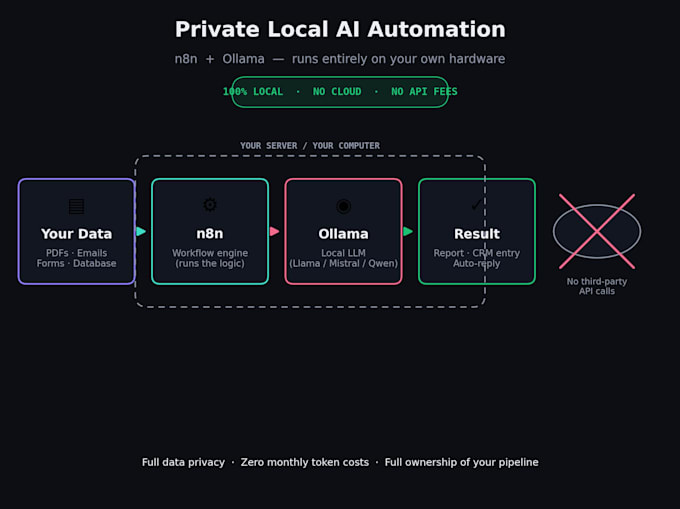
¿Quieres automatización con IA sin riesgos de privacidad o tarifas elevadas por tokens? Construyo sistemas de IA autoalojados usando n8n + Ollama, que funcionan completamente en tu hardware o servidor privado.
¿Por qué IA local?
100% privacidad de datos, nada sale de tu infraestructura
Sin costos de API, uso ilimitado de Llama 3, Mistral, Qwen, DeepSeek
Propiedad total de tu servidor, flujos de trabajo y parámetros LLM
Lo que construyo:
Cómo trabajamos:
1️ Descubrimiento definir metas y necesidades de seguridad
2️ Configurar n8n + Ollama en tu hardware/VPS
3️ Construir, diseñar, probar y optimizar tu lógica de IA
4️ Entrega de documentación completa + video explicativo
AI Automation and Private LLM Specialist,n8n and Ollama Expert
Idiomas
Traducción automática
Traducción automática
¿Necesito hardware potente para ejecutarlo localmente?
Depende del tamaño del modelo de IA. Los modelos más pequeños funcionan bien en un CPU moderno o una GPU de gama media. Para modelos más grandes o respuestas más rápidas, se recomienda una GPU (incluso una de consumo como una RTX 3060+). Revisaré tus especificaciones durante el descubrimiento y recomendaré el modelo adecuado para tu configuración — sin conjeturas.
No tengo un servidor, ¿aún puedes ayudarme?
Sí. Si no tienes hardware local o VPS, puedo ayudarte a configurarlo (por ejemplo, Hetzner, DigitalOcean, Contabo) como parte del proyecto, o recomendarte un proveedor que se ajuste a tu presupuesto y necesidades.
¿Mis datos realmente permanecerán privados?
Sí — con esta configuración, tus datos nunca salen de tu propia infraestructura. A diferencia de las APIs de IA en la nube (OpenAI, etc.), no hay llamadas externas enviando tus datos a terceros. Todo funciona localmente.
¿Un modelo open-source local (Llama, Mistral, Qwen) es tan bueno como ChatGPT/GPT-4?
Para tareas empresariales bien definidas (extracción de documentos, puntuación de leads, preguntas internas), los modelos locales funcionan muy bien y a menudo son "suficientemente buenos" o mejores una vez ajustados a tu caso de uso. No están diseñados para reemplazar chatbots de propósito general en todas las tareas.
¿Qué pasa después de la entrega — puedo hacer cambios yo mismo?
Sí. Recibirás documentación completa y un video explicativo que muestra cómo funciona el flujo de trabajo, para que tú (o tu equipo) puedan hacer ajustes básicos de forma independiente. También estoy disponible para soporte y mantenimiento continuo si prefieres no gestionarlo tú mismo.
¿Cuánto tarda la entrega?
El tiempo de entrega depende del paquete y la complejidad del proyecto — consulta los niveles de precios arriba. Las integraciones complejas (base de datos, ajuste fino) toman más tiempo y se reflejan en los paquetes Estándar/Premium.
¿Qué pasa si el modelo no entiende bien mis documentos/datos?
Eso es exactamente para lo que sirve la fase de descubrimiento — probamos con una muestra de tus datos reales desde el principio, para detectar problemas de precisión antes de la entrega completa, no después.
¿Ofreces mantenimiento continuo después de entregar el proyecto?
Sí, esto puede organizarse por separado como un retainer mensual si quieres que siga manteniendo, actualizando o extendiendo tus flujos de trabajo después de la entrega.
